30. listopadu 2012

Technologické blogování

Už tomu bude skoro dva roky, co jsem začal blogovat (na SW Samuraj trochu míň). To samozřejmě není mnoho a ještě mě čeká dlouhá cesta.

Na jaře jsem si dělal malou rekapitulaci, jak se můj blog vyvíjí a chtěl bych se k tomu pravidelně (ročně) vracet. Tady mě silně inspiroval Otec Fura, byť své shrnutí chci pojímat trochu jinak.

Pro blogování můžou být různé důvody. Třeba pro mne je to způsob, jak se dále vzdělávat, zlepšovat, posouvat své hranice. Z hlediska vzdělávání se, je blogování trochu specifické a trochu to připomíná dávné doby SW inženýrství - informací je pomálu, ti kdo to pořádně umí, o tom moc nepíšou, dobrou radu aby člověk pohledal (Google moc nepomůže. No, možná jsem se jen málo snažil).

Jako knihomol ocením, když je k nějakému tématu kniha. Et Voilà, letos vyšla kniha, která se věnuje technologickému blogování (přesnější překlad by byl odbornému): Technical Blogging. Její autor Antonio Cangiano postupně prochází jednotlivé fáze, kdy se z neznámého bloggera stane světová hvězda vydělávající miliony dolarů :-)

Zas tak divoký to samozřejmě není. Antonio píše velmi čtivě, metodicky a má spoustu dobrých rad, vykoupených vlastní zkušeností. Kniha je v podstatě takové how-to, kdy se do hloubky probírají témata jako:

  • Plánování blogu. Proč to vlastně chci dělat? Budu psát sám, nebo to bude kolektiv? Bude to obecnější blog, nebo bude specificky zaměřen? Apod. A taky založení domény.
  • Vytvoření blogu. Antonio doporučuje rozjet vlastní instanci WordPressu, ale neopomíjí další řešení jako Blogger. WordPress.com, nebo statické generátory jako Jekyll.
  • Vyšperkování (vytunění) blogu. To jsou takový ty serepetičky, co má každý blog v pravý liště a v patičce. Dá se tam sice nacpat skoro cokoliv, ale měly by tam být hlavně věci, které slouží čtenářům (pro lepší orientaci) a autorovi (k rozumné propagaci).
  • Vytváření mimořádného obsahu. To je alfa a omega každého blogu. Lidi to čtou, protože je to zajímá, pomáhá jim to, baví je to, odpovídá to jejich očekávání atd. Je to v podstatě jednoduché ;-)
  • Pravidelné publikování. Antonio píše, že je přímá úměra mezi četností a pravidelností článků a množstvím čtenářů - čím častěji (a pravidelněji), tím víc.
  • Promoting blogu. Jak se z neznámého autora stát známým (a čteným). Něco o SEO, sociálních sítích a komunikaci.
  • Statistiky návštěvnosti. Aneb jak porozumět výrazům jako visit, unique visitor, pageview, average pageview, time on site, bounce rate a new visit. A samozřejmě Google Analytics.
  • Benefity blogování. Sem spadá kromě monetizace také promo vlastního businessu, zlepšení skillů a rozvoj kariéry. Plus pár dalších drobností.
  • Škálování. Věřte nebo nevěřte, blog se dá taky vertikálně a horizontálně škálovat. Buď najmout více lidí (autorů), nebo založit blogovací impérium.
  • Strategie pro sociální média. Blogy nejsou odříznutý od světa, ale existujou v oceánu internetu, kterému čím dál více vládnou sociální média. Neškodí tedy o nich alespoň něco málo vědět (a využít je).

Tak, komu bych knihu doporučil? Určitě začínajícím a mírně pokročilým blogerům, pro ně bude zdrojem neocenitelných informací. Ostříleným blogujícím mořským vlkům bych spíš poradil investovat těch $20 do něčeho jiného. No a doporučením samo o sobě je edice: Pragmatic Programmer.

Na závěr ještě pár citátů, který jsem si na Kindlu podtrhnul:

"Sadly, the most common type of blog is the abandoned one."

"Visitors value eye candy."

"Remember that blogging is mostly about spreading ideas."

"Whatever voice you develop, become a bit of a storyteller. People love strories that go with useful information."

"So-called trolls feed on replies. The good old Usenet mantra says, 'Don't feed the trolls.'"

"When you are researching a topic for an article, you'll be doing focused learning for a specific and practical purpose (something that turns out to be very effective)."

"There is a strong correlation between how much you publish and how popular your blog is."

"Building a remarkable online presence takes years, not days."


21. listopadu 2012

Životní cyklus webových služeb

Jedním z aspektů SOA governance, který by se měl zvážit, pokud začneme s verzováním služeb, je definování a správa životního cyklu služeb (service lifecycle). Podobně jako se u vystavených rozhraní služeb snažíme, aby jejich změny byly pro uživatele předvídatelné a srozumitelné (k čemuž nám pomůže snaha o zpětnou kompatibilitu a verzování), měli bychom se podobně snažit o srozumitelnost a předvídatelnost ohledně (časové) dostupnosti služby samotné.

SOA jako taková, je poměrně volné téma, takže každý dodavatel řešení k ní přistupuje po svém (a většinou si ji ohýbá, podle svého technologického a business portofolia. Výjimkou je v tomto většinou open source, který se snaží implementovat podle návrhových vzorů a nemá přitom vedlejší úmysly). Podobně kreativní jsou výrobci i v oblasti životního cyklu SOA služeb. Pokud bysme chtěli vědět, jak vypadá nějaký "obecný" lifecycle, tak brzy zjistíme, že žádný takový není.

Service Lifecycle podle ITIL
Obecně má lifecycle nějaké hlavní fáze, rozdělené do dílčích fází. Např. Oracle má hlavní fáze pouze dvě (design a runtime), ITIL má tři (design, transition a operation) a IBM čtyři (model, assemble, deploy a manage).

Service Lifecycle podle IBM (zdroj IBM)
Pokud bychom si však přesto chtěli takový obecný lifecycle načrtnout, mohlo by to vypadat nějak takto: Na počátku je vždycky požadavek na novou business funkčnost, což by mělo vést k analýze - jestli může požadavek pokrýt nějaká stávající služba/y (nebo jejich kompozice), jestli bude potřeba stávající službu upravit (pak se musí udělat dopadová analýza - impact analysis), nebo jestli vznikne úplně nová služba. Když jsou tyto věci jasný, může se služba zaplánovat (např. kdy se nasadí na produkci).

Service Lifecycle podle Oracle (zdroj Oracle)
Následuje klasický vývojový cyklus, tj. analýza, vývoj a testování služby, nasazení na různá prostředí a pak se služba dostane do produkční fáze - začnou ji používat klienti. Časem se může stát, že služba už nebude splňovat požadavky na ni kladené, změní se požadavky a služba už nebude potřeba, anebo vznikne nová verze služby. Je čas, aby služba odešla do důchodu.

Skutečná podoba lifecyclu se ale bude vždycky odvíjet od procesu, který daná organizace má (nebo by měla mít) pro správu a řízení IT artefaktů. Protože SOA governance je pořád jen podmnožina (a rozšíření) IT governance.

Pokud máme vydefinovaný životní cyklus služby, naskýtá se otázka, kde jej spravovat. Ano, nabízejí se jednoduchá a přímočará řešení - už jsem viděl případy, kdy byla governance služeb držená v Excelu, nebo ji tvořily tři(!) tabulky v databázi. Pokud se však nechceme vydat touto svůdnou cestou a nechceme znovu vymýšlet kolo, je vhodné použít nějakou SOA governance repository.

Toto bývá dost často kamenem úrazu celé SOA governance, protože komerční repository jsou častokrát dražší, než celé zbývající SOA řešení. Pokud však nemáme velké oči (ještě nikdy jsem neviděl SOA governance implementovanou v celé své šíři), dají se, se stejným úspěchem, využít i open source řešení.

Například my jsme na projektu použili WSO2 Governace Registry, profesionální open source řešení, které (prozatím) splňuje naše požadavky. Ke každé registrované (a spravované službě) se dá přiřadit nějaký lifecycle (každá služba může mít jiný) a nastavit konkrétní fázi.


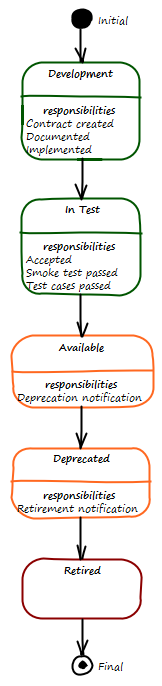
Lifecycle, který jsem pro aktuální projekt adaptoval vypadá následovně. Životní cyklus se skládá z několika stavů, kdy každý z nich může mít několik požadavků, které musí být splněny, aby se služba mohla posunout do dalšího stavu. Cyklus je znázorněn pomocí UML state diagramu, jednotlivé požadavky jsou zobrazeny jako responsibilities:

  • Initial: Začátek lifecyclu, resp. procesu pro správu a životní cyklus služby. U nás takový proces de facto chybí a je nahrazen požadavky jednotlivých projektů. To je samozřejmě z hlediska SOA governance špatně - služba totiž nepřestane existovat jen proto, že je nasazena na produkci a je akceptována (což je pohled projektu).
  • Development: Tady pro nás začíná design fáze lifecyclu (na obrázku zeleně).
  • Contract created: bylo vytvořeno WSDL a bylo akceptováno konzumenty.
  • Implemented: služba byla plně vyvinuta a nasazena na prostředí, kde ji můžou (integračně) otestovat klienti.
  • Documented: služba byla zdokumentována. Pro nás to znamená, že byl jednak plně okomentáván kontrakt (elementy v XSD a služba a operace ve WSDL) a jednak byla zdokumentována orchestrace a externí komunikace služby pomocí CASE nástroje.
  • In Test: Služba byla nasazena na testovací prostředí. Není explicitně řečeno jaké (FAT/SIT/UAT), protože jednotlivé požadavky se týkají různých prostředí.
  • Smoke test passed: release manager ověřil, že služba po nasazení na SIT prostředí "žije".
  • Test cases passed: test manager nechal projít všechny test casy a schválil posunutí služby do UAT testů.
  • Accepted: služba byla akceptována v rámci UAT testů.
  • Available: služba byla na sazena na produkční prostředí a je tak k dispozici konzumentům. Zde začíná run-time fáze cyklu (oranžově).
  • Deprecation notification: konzumenti služby byli notifikování, že služba k nějakému datu přejde do stavu deprecated.
  • Deprecated: služba je označena jako deprecated (určena k penzionování), nicméně stále je ještě k dispozici konzumentům. Pokud je služba označena jako deprecated, je zpravidla již k dispozici její novější verze (jejíž nasazení by mělo být synchronizováno s tímto stavem). Výjimkou může být, pokud je služba rušena bez náhrady - v tom případě je služba označena jako deprecated, ale není nasazena její novější verze.
  • Retirement notification: konzumenti služby byli notifikováni, že služba k nějakému datu přejde do stavu retired.
  • Retired: služba byla penzionovaná - stažena z používání a je klientům nedostupná. Služba v tomto stavu by stále měla být evidovaná v SOA governance repository. Například proto, aby bylo dohledatelné, v jakém časovém rozmezí byla služba aktivní apod.

Na závěr ještě malá ukázka, jak vypadá část lifecyclu v nástroji WSO2 Governace Registry:


U služby je vždy zobrazen aktuální stav cyklu, požadavky stavu jsou prezentovány checkboxy. Pokud služba splňuje podmínky přechodu do dalšího stavu (a tento stav skutečně již nastal), lze službu posunout do dalšího stavu tlačítkem Promote. Přechody mezi stavy a splnění požadavků lze svázat s formální kontrolou (např. kontrola verzí závislých artefaktů) a konkrétní uživatelskou rolí.

Související články:

8. listopadu 2012

Jak dělám Java pohovor

[UPDATE] Ačkoliv je tento článek bezkonkurenčně nejčtenější na mém blogu, je značně zastaralý. Samozřejmě zde můžete najít nějakou inspiraci, ale doporučuji radši některý z následujících dvou článků, anebo kerýkoli z kategorie interview.
[/UPDATE]

Už je to nějaký čas, co jsem četl výbornou knížku Managing Humans, na kterou mne kdysi upozornil post Lukáše Křečana Vedeme lidské bytosti (můj post Manažerem humorně a kousavě). Jedna z kapitol, která mě zaujala (a inspirovala) pojednávala o tom, jak Rands (autor) řeší pohovory s kandidáty.

Už delší dobu si pohrávám s myšlenkou, že bych něco pododbného sepsal taky - jednak, pro lidi, kteří jdou na podobný pohovor, protože takových informací moc není a jednak, abych si udělal jakési interní review. Když před nedávnem o něčem podobném psal Dagi (Jak si (ne)zruinovat životopis), řekl jsem si, že to je správný impuls, podívat se na toto téma zevrubněji.

Abych to uvedl trochu do kontextu, řeknu něco o tom v jaké roli v tom figuruju já. Ač nejsem na manažerské pozici, tak určitá míra neustále se zvyšující seniority :-) mě přivedla k tomu, že lidé z HR, salesu/businessu a naší outsorcové agentury (naše firma mám vlastní) mě začali zvát na pohovory s javistama jako technického přísedícího, což se postupně vyvinulo (v rámci hiringu) v regulérní technické java pohovory. V současnosti tak dělám cca  25 java pohovorům ročně.

CV

Než jdu na pohovor, tak samozřejmě dostanu k dispozici CV. Než se CV dostane ke mně, projde rukama ještě jiných lidí, kteří mají různá kritéria výběru, ale podle čeho se rozhoduje paní z HR, nebo pán z agentury, to vám věru neřeknu. Nicméně mě zajímá:

Jméno. První co udělám s novým CV, podívám se, jestli má daný člověk (říkejme mu kandidát) profil na LinkedIn. Tam se dají občas zjistit zajímavý (profesní) věci, které v CV nejsou. Třeba doporučení. Nebo že někdo, koho znám já, zná toho kandidáta. Nebo projekty, který v CV nejsou.

Projekty. Projekty jsou pro mne gró celého CV. Dá se z toho odvodit, pro jaké firmy a zákazníky kandidát pracoval, jak dlouho byl na daném projektu, někdy jeho role, technologie a domény se kterými se mohl setkat apod.

Většinou mám nějakou představu, na jaký náš projekt by kandidát šel, nebo proč ho vůbec chceme přijmout, takže si v CV podtrhnu inkriminované technologie a ptám se na ně u pohovoru. Taky si můžu podtrhnout technologie, které mne zajímají ve spojitosti se senioritou - pokud je někdo senior, tak očekávám že u SVN umí víc než komit a checkout. Zrovna tak u Mavenu čekám, že bude umět víc jak mvn clean install. Naopak, pokud si junior napíše do CV continuous integration, tak je nejspší jasný, že to používali na projektu, ale nastavit to neumí.

Školení a certifikace. Tohle je pro mne míň podstatné. ale je to střípek do mozaiky. Dělá někdo certifikace? Evidentně na sobě pracuje. Chodí někdo na školení? Evidentně má zajem se vzdělávat a umí si to zařídit. S těma školeníma je to docela zajímavý - spousta lidí má kvanta školení, který rázem končí rokem 2007. Pak přišla krize a šmitec. Pokud má někdo školení po roce 2008, je dost pravděpodobné, že si to musel vybojovat.

Tak, to bylo, co mě zajímá. A co mě vůbec nezajímá:

Vzdělání. Ze zvědavosti se kouknu, ale nepřikládám tomu žádný význam. Obecně, v životě už jsem viděl příliš mnoho vysokoškolsky vzdělaných idiotů. Pokud se budu držet tématu, je tady jakási trojka škol, které by měly kralovat IT - Matfyz, FEL a FI MUNI. Ale v praxi neznamená škola vůbec nic. Viděl jsem výborného vývojáře z VŠE, nebo excelentního vývojáře bez vejšky. (jo, taky jsem takovej bejval :-)

Zájmy. Ze zvědavosti se někdy kouknu a nepřikládám tomu žádný význam. Že hraje někdo fotbal? Hm, spíš než "týmového hráče" vidím, že budu v openspace poslouchat jak zase hrála Sparta nebo Barcelona :-/ Má někdo rád literaturu? Hm, co to znamená? Sci-fi, fakta, fantasy, historie, Viewegh, Kierkegaard? Hm, hm, taky čtu knížky (jako miliarda dalších).

Summary. Takový to: 15 let praxe, bla, bla, bla... Zcela ignoruju a nikdy nečtu.

Pohovor

Ještě před pohovorem si nechám od kandidáta poslat ukázku jeho kódu dle vlastního výběru. Kód si natáhnu do IDE, projdu ho a pomocí TODO si označím, na co se budu ptát u pohovoru (většinou tak kolem pěti věcí). Pak už přijde ten velký den a sejdeme se s kandidátem v jedné místnosti.

Po formalitách - podání ruky, kafíčko/voda/čaj a ev. přeptání se na cestu, pokud je zdaleka - zasedneme ke stolu a jdeme na to. Pohovor mám naplánovaný na hodinu a má následující agendu, kterou zmíním hned na začátku:
  1. představím se já,
  2. [updated] prostor pro kandidátovy otázky, [/updated]
  3. projdeme kandidátovo CV,
  4. podíváme se na kandidátův kód,
  5. podíváme se na můj kód,
  6. překvapení na závěr ;-)

Podrobněji:

1. představím se já. velice krátce vysvětlím svoji roli a pozici ve firmě. Něco jako: "Já jsem Guido, solution architect a leader Java kompetence, bla, bla." Celkem 3-4 věty.

2. [updated] prostor pro kandidátovy otázky. Tady se mně kandidát může na cokoliv zeptat. Bývám velmi otevřený, ovšem jsem schopen zodpovědět pouze technické a projektové otázky. Věci finanční a alokační se řeší v jiných kolech pohovoru. Z osobní zkušenosti můžu říct, že se lidé ptají velmi málo. To, že by někdo měl připravené otázky dopředu se stává velmi výjimečně. Pokud se tak však stane, je to jasné plus.[/updated]

3. projdeme kandidátovo CV. Požádám kandidáta, aby se představil z hlediska posledních projektů, které dělal, nebo z hlediska projektů, které mají vztah ke konkrétní požadované znalosti (např. integrace). Tady většinou podrobněji projdu roli, kterou kandidát na projektu měl a vůbec jeho orientaci v tom, jak byl projekt nastavený - týmy, role, struktura, metodiky apod.

Pak si popopvídáme o technologiích, které jsem si předtím podtrhl v CV (viz Projekty výše). Můžu se zeptat např. na JPA: co to je, jak to funguje, nějaký detail. Můžeme jít dost do hloubky, záleží na okolnostech. V této fázi se jasně obnaží, jak moc je CV "vyšperkovaný". Taky je to část, kdy si začnu dělat názor na kandidátovu senioritu.

4. podíváme se na kandidátův kód. Promítnu kandidátův kód, tak aby ho všichni viděli a formou diskuze se pobavíme nad věcmi, které jsem si v kódu předtím označil pomocí TODO. Většinou si označím věci, které považuju za (potenciální) chyby, chybný design, věci kterým nerozumím, nebo věci který mě zaujmou. Tady vycházejí najevo věci, které jsou hodně technického charakteru. A z jejich severity si opět skládám kandidátovu senioritu.

Jak jsem psal výše, jde o kód dle kandidátova vlastního výběru. Předpokládám tedy, že kandidát svůj kód zná a případné dotazy dokáze zodpovědět a rozhodnutí obhájit. Taky předpokládám, že když jde o pohovor, tak pošle ten nejlepší kód, kterým se může prezentovat. Pokud tomu tak není, tak to o něčem vypovídá a pro mne jsou to jasné body dolů.

5. podíváme se na můj kód. Před časem jsem dělal jeden "rozsáhlý refactoring", ehm, bylo potřeba přepsat třetinu aplikace. Protože aplikace byla už nasazená na produkci, byl od zákazníka velký tlak na korektní provedení a review nové verze. Proto vznikl prvně prototyp, který ověřil nový koncept a po jeho akceptaci se teprve implementovala nová verze. Proč o tom mluvím? Ten prototyp je hrozně vymazlený, doslova briliantový - krystalicky čistý design, kvanta statické analýzy kódu, Javadocy atd.

Právě tenhle prototyp (celý, ne moc velký projekt), natažený v IDE a opět promítaný, dám na notebooku k dispozici kandidátovi a nechám ho nahlas komentovat a nahlas přemýšlet, co ho na projektu/kódu zaujme, co si o tom myslí atp. Tady mám opět nějaká, senioritou daná očekávání, třeba že zkušenější člověk může (sám od sebe) něco říct o layoutu projektu, nebo nastavení Mavenu. Pokud řeč vázne, trošku debatu směruju k nějakému zajímavému tématu.

V téhle části nemám dopředu připravené konkrétní věci, které bych chtěl slyšet, nebo na které se ptát. Improvizuju. Což si, myslím, můžu dovolit - ten kód velmi dobře znám a už předešlá diskuze nad kandidátovým kódem by měla navodit komunikativní atmosféru.

6. překvapení na závěr. Posleních cca 10 minut pohovoru a... vytáhnu hlavolam 8-o Mám rád hlavolamy japonské firmy Hanayama a dva z nich si beru na pohovor. Kupuju si ty s těžší řešitelností a jelikož nejsem žádný genius, trvá mi jejich vyřešení hodiny až dny. Postavím tedy dva hlavolamy před kandidáta a hned na úvod ho uklidním, že v žádném případě nechci, aby nějaký z nich vyřešil. Pokud by se mu to náhodou povedlo, byl by to příjemný, ale zcela nepodstatný bonus.

Následně mám pro kandidáta dvoudílné zadání: ať si vybere hlavolam, se kterým mu půjde to zadání lépe naplnit a zkusí slovně popsat:
  1. samotný hlavolam - z čeho se skládá, na jakém principu může fungovat apod.
  2. postup, jak by hlavolam šel vyřešit. Ideálně tak, aby podle tohoto postupu jej byl schopen vyřešit někdo jiný.
Hlavolam je tady samozřejmě zástupným problémem. Smyslem téhle části je, jestli je kandidát schopen poslouchat zadání a zkusit ho naplnit. A ne se vrhnout na řešení problému, to zadavatel nechtěl.

U první části navíc pobízím kandidáta, aby se nebál říct byť triviální věci. Ono se může zdát hloupé říct, že nějaká část je kovová, nebo stříbrná. Protože když člověk "drží" problém v ruce "je to přece jasné". Ale pokud to máte někomu jinému vysvětlit (třeba businessu), tak už to tak zřejmé být nemusí.

Pokud se kandidát začne odchylovat od zadání druhé části, zkusím ho navést zpátky příkladem z vodopádového vývoje - analytik nebo architekt něco zanalyzuje a předá to vývojáři a ten podle toho vyvíjí. Teoretických postupů, jak hlavolam může být řešen je mnoho a fantazii se meze nekladou.

No a to je všechno. Pak už jsou jenom takové ty závěrečné formality a pak sepíšu hodnocení. Ale to už je jiný příběh.

Závěr

Myslím, že jsem svůj postup popsal celkem otevřeně a dokážu si představit, že někdo nevěřícně kroutí hlavou, proč někdo vyzrazuje své know-how, ba dokonce může ohrozit věrohodnost a smysluplnost celého procesu. Takový přístup chápu, nicméně nejsem jeho stoupencem. Naopak.

Jsem odkojenej open source a i v manažmentu (v mém případě spíš teamleadingu) vyznávám přístup založený na šíření informací, než na jejich zadržování. Stejně tak i ve vývoji, mám rád, když se informace sdílí - pokud senior mentoruje juniory, tak to není o tom, že jim zadarmo předá svoje znalosti (zkušenosti jsou nepřenosné), ale že tím obohatí i sám sebe. Myslím si, že sdílení znalostí je znakem vyšší formy seniority. V reálu to sice má své hranice (a ani já nejsem libertarián), ale je to legitimní způsob života.

Na a jestli si nějaký budoucí kandidát tenhle postup přečte a připraví se podle toho na můj pohovor? Říkám: skvěle! Pokud se někdo jakýmkoliv (korektním) způsobem připraví na pohovor, je vidět, že chce uspět a to je jednoznačné plus.

A úplným závěrem. Budu moc rád, pokud se v diskuzi podělíte o své názory a zkušenosti, ať už z jedné nebo druhé strany pohovoru.

5. listopadu 2012

Verzování XSD v SOAP webových službách

Když jsem psal minule o verzování SOAP webových služeb, zaměřil jsem se pouze na verzování v rámci WSDL. Letmo jsem také popsal WSDL strukturu, s tím, že jsem nijak neřešil definici datových typů. Tady se může skrývat další úskalí (nebo příležitost pro) verzování.

Datové typy jsou uvedeny v elementu types. Pokud není definice typů triviální, nebo pokud není ve službě definovaná pouze jedna operace, tak se zpravidla drží definice externě v XSD souboru a do WSDL se pouze naincludují (pokud chceme mít typy ve stejném namespace, jako má WSDL), nebo naimportují (pokud chceme, aby XSD mělo samostatný namespace).

Myslím, že je lepší používat element import. Kromě toho, že je to podmínka, aby kontrakt splňoval WS-I Basic Profile, tak to umožňuje dodržovat následující konvenci:
  1. Součástí namespace WSDL je název služby.
  2. Každá operace má svoje vlastní XSD (v němž je definovaný request a response).
  3. Součástí namespace XSD je název služby a název operace.
  4. Plus samozřejmě verzujeme.
Takže pokud bysme měli službu s názvem MyService a operaci s názvem myOperation, tak by namespacy vypadaly takto:

WSDL:
http://sw-samuraj.cz/ws/MyService-v1

XSD:
http://sw-samuraj.cz/ws/MyService-v1/myOperation

Podobně jako u WSDL, je v namespace uvedena pouze major verze a jelikož je už ji obsahuje název služby (MyService-v1), není potřeba ji duplikovat ještě v názvu operace.

Kromě namespaců verzujeme také samotný XSD soubor, např. myOperation-v1.2.xsd. Což nás staví před následující dilema. Představme si, že máme službu, která obsahuje dvě operace. Něco jako:
<?xml version="1.0" encoding="UTF-8"?>
<definitions
  targetNamespace=
      "http://sw-samuraj.cz/ws/MyService-v1"
  xmlns="http://schemas.xmlsoap.org/wsdl/"
  xmlns:soap="http://schemas.xmlsoap.org/wsdl/soap/"
  xmlns:xsd="http://www.w3.org/2001/XMLSchema">

  <types>
    <xsd:schema>
      <xsd:import
        namespace=
          "<trimmed>/MyService-v1/myOperation"
        schemaLocation="xsd/myOperation-v1.2.xsd"/>
      <xsd:import
        namespace=
          "<trimmed>/MyService-v1/yourOperation"
        schemaLocation="xsd/yourOperation-v1.2.xsd"/>
    </schema>
  </types>

  <!-- messages omitted -->

  <portType name="MyServicePort-v1.2">
    <operation name="myOperation">
      <!-- input, output and fault omitted -->
    </operation>
    <operation name="yourOperation">
      <!-- input, output and fault omitted -->
    </operation>
  </portType>

  <!-- binding omitted -->

  <!-- service omitted -->

</definitions>
Dilema zní: pokud dojde ke změně kontraktu pouze v rámci jedné operace, změním verzi pouze u XSD, které této operaci odpovídá, nebo změním verzi u všech XSD, které jsou součástí kontraktu? (V obou případech samozřejmě verzujeme WSDL tak, jak bylo uvedeno v předešlém článku.)

Pokud by se nám změnila operace myOperation, tak v prvním případě by import vypadal takto:
<types>
  <xsd:schema>
    <xsd:import
      namespace=
        "<shortened>/MyService-v1/myOperation"
      schemaLocation="xsd/myOperation-v1.3.xsd"/>
    <xsd:import
      namespace=
        "<shortened>/MyService-v1/anotherOperation"
      schemaLocation="xsd/anotherOperation-v1.2.xsd"/>
  </schema>
</types>

<portType name="MyServicePort-v1.3">
<!-- rest omitted -->
Výhodou této volby je, že verzujeme pouze XSD, u nichž opravdu došlo ke změně, zbytek necháváme na pokoji. Nevýhodou je, že verze XSD se nám rozjedou - jednak vůči sobě a jednak vůči WSDL. Reálně pak verzujeme XSD jako samostatný artefakt a ne jako součást kontraktu. To může být korektní situace, někdy vznikají XSD bez vazby na WSDL - v rozsáhlých projektech jsou často XSD vytvářena týmy analytiků a jejich import do WSDL zajišťují vývojáři.

V případě druhé možnosti by import vypadal následovně:
<types>
  <xsd:schema>
    <xsd:import
      namespace=
        "<shortened>/MyService-v1/myOperation"
      schemaLocation="xsd/myOperation-v1.3.xsd"/>
    <xsd:import
      namespace=
        "<shortened>/MyService-v1/anotherOperation"
      schemaLocation="xsd/anotherOperation-v1.3.xsd"/>
  </schema>
</types>

<portType name="MyServicePort-v1.3">
<!-- rest omitted -->
Nevýhodou této možnosti je, že musíme převerzovat všechy XSD v kontraktu, i ty, které se nezměnily (což se může zdát nepřirozené). Výhodou je, že kontrakt má jednotné verzování, takže mmj. nemusím kontrolovat jestli mám všechny XSD ve správné verzi. Zároveň je explicitně řečeno, že XSD je součástí kontraktu (ve smyslu objektové kompozice) a kontrakt (WSDL + XSD) by měl být vytvářen jedním týmem.

U nás na projektu o tom byla poměrně bouřlivá diskuze, kterou variantu zvolit. Argumenty byly poměrně vyrovnané a více méně odpovídaly těm uvedeným výše. Nakonec jsme se rozhodli pro jednotný kontrakt, takže se změnou verze WSDL převerzováváme i všechny XSD.

23. října 2012

Verzování webových služeb, SOAP

Před časem jsem napsal lehký úvod do SOA governance. Chtěl bych se k tomuto tématu vracet a prezentovat principy, které postupně zavádíme na projektu. Momentálně nás daleko víc pálí věci, které spadají do design fáze služeb, takže řešíme věci jako verzování, reusabilita, granularita služeb apod.

Aspekt, který jsme řešili jako první (a nyní už i zavedli v praxi) je verzování služeb. Jelikož používáme řešení založené na SOAP webových službách (jak jinak v enterprise :-) podíval bych se právě na toto téma. Jestliže budu dále mluvit o webových službách (WS), mám tím vždy na mysli WS založený na SOAP.

Proč?

Otázka je, proč vlastně webové služby verzovat? Dejme tomu, že z nějakého důvodu chceme, na určitém prostředí, držet více verzí jedné služby. Tím důvodem může být např. to, že už máme nějaké stávající konzumenty dané služby a zároveň chceme touto službou poskytnout nové (business) funkcionality. Stávající klienti ovšem nemohou (nebo také odmítnou) přejít na novou verzi služby. Starou verzi služby tedy necháme funkční a zároveň nasadíme verzi novou. V případě SOA by toto mělo být definováno/podpořeno nějakou politikou, např. podpora více verzí služeb.


Kontrakt

Jak z hlediska SOA, tak z hlediska klienta se webová služba (a její konzumace) točí kolem kontraktu. Kontrakt, jako takový, se skládá z několika částí. Jednak definuje nějaké designové věci jako datové typy, zprávy a rozhraní (ve smyslu OOP). Dále definuje technologické záležitosti, tj. jaké se používají protokoly, jaké jsou endpointy služby. A konečně jsou to nefunkční požadavky.

Pro SOAPovské služby je tímto kontraktem WSDL (Web Service Definition Language). Pokud pomineme nefunkční požadavky (které stejně nejsou definovány ve WSDL namespacu, ale jinde), má WSDL následující strukturu (zeleně jsou designové části, červeně implementační):

  • types - element definující pomocí XML Schema datové typy používané ve zprávách.
  • message - abstraktní definice přenášených dat (zpráv), sestavená z typů definovaných v předešlém elementu. Každá zpráva se skládá z jedné a více logických částí (parts). Pokud je částí ve zprávě více, jde o službu založenou na RPC.
  • portType - množina abstraktních operací, víceméně odpovídá rozhraní v OOP. Každá operace (metoda) by měla odkazovat vstupní a výstupní zprávu. Operace může být jedním ze čtyř typů: Request-response (klasika), One-way (obsahuje pouze vstupní zprávu), Notification (obsahuje pouze výstupní zprávu) a Solicit-response (endpoint pošle zprávu a očekává odpověď).
  • binding - sváže definovaný portType s konkrétním protokolem (SOAP, HTTP, JMS) a formátem zpráv (např. Document/literal, RPC/encoded).
  • port - definuje endpoint služby.
  • service - množina souvisejících portů.

Sémantika verzování

Není potřeba znovu-vymýšlet-kolo. Archetypem verzování je formát <major>.<minor>.<micro>. U služeb nás micro verze nebude moc zajímat - je vyhrazená pro implementační změny, které neovlivňují vyšší řády verze a nijak se tedy nepromítají do kontraktu. minor verze je vyhrazená pro změny rozhraní, které jsou zpětně kompatibilní. No a major verze indikuje změnu rozhraní, která není zpětně kompatibilní, tj. rozbíjí kontrakt.

Změny, které jsou zpětně kompatibilní:
  • přidání nové operace do služby,
  • přidání nového XML typu do schématu.

Změny, které nejsou zpětně kompatibilní:
  • odebrání operace ze služby,
  • přejmenování operace,
  • změna XML typů a atributů zprávy,
  • změna namespace.

Jak?

Jako best-practice se uvádí, že verzování by pro konzumenty mělo být explicitní, tj. uvádět číslo verze v elementech, URL apod. Co všechno v kontraktu verzovat, může být předmětem diskuzí na konkrétním projektu a technologiích, nicméně dá se vyjít z těchnto pravidel:
  1. Vkládat major a minor verzi do názvu WSDL souboru: MyService-v1.2.wsdl.
  2. Vkládat major verzi do targetNamespace WSDL souboru:
    <definition
      targetNamespace=
          "http://sw-samuraj.cz/ws/MyService-v1"
      xmlns="http://schemas.xmlsoap.org/wsdl/">
  3. Vkládat major a minor verzi do portType elementu:
    <portType name="MyServicePort-v1.2">
  4. Vkládat major a minor verzi do service elementu:
    <service name="MyService-v1.2">
  5. Vkládat major verzi do endpointu služby:
    <soap:address
      location=
        "http://sw-samuraj.cz/myService/v1"/>
Pokud bychom si ukázali celé WSDL, vypadalo by takto:
<?xml version="1.0" encoding="UTF-8"?>
<definitions
  targetNamespace=
      "http://sw-samuraj.cz/ws/MyService-v1"
  xmlns="http://schemas.xmlsoap.org/wsdl/"
  xmlns:soap="http://schemas.xmlsoap.org/wsdl/soap/"
  xmlns:xsd="http://www.w3.org/2001/XMLSchema">

  <types>
    <xsd:schema
      targetNamespace=
            "http://sw-samuraj.cz/ws/MyService-v1">
      <!-- schema omitted -->
    </xsd:schema>
  </types>

  <!-- messages omitted -->

  <portType name="MyServicePort-v1.2">
    <!-- operations omitted -->
  </portType>

  <!-- binding omitted -->

  <service name="MyService-v1.2">
    <port binding="MyServiceSOAP"
          name="MyServiceSOAP">
      <soap:address
        location="http://sw-samuraj.cz/myService/v1"/>
    </port>
  </service>

</definitions>

Závěr

Verzování poměrně úzce souvisí s dalším SOA governance aspektem a sice životním cyklem služeb (což je téma, na které se podíváme někdy příště). To že držíme na prostředí (typicky produkci) více verzí jedné služby má samozřejmě svoje náklady a ideálním stavem je, když služba běží pouze v jedné (nejaktuálnější) verzi.

Se správou více verzí nám může pomoci vhodný nástroj - SOA governance repository, která drží o konrétní verzi služby různá meta-data a mmj. také to, v jaké životní fázi se služba nachází, nebo kdo ji konzumuje (a koho musíme notifikovat o penzionování služby).

4. října 2012

Architektonické principy RESTu

Jedním ze zdrojů, který jsem použil jako přípravu na certifikaci Java EE 6 Web Services Developer (o které jsem psal nedávno), je kniha RESTful Java with JAX-RS od Billa Burkeho. Bill je určitě vhodným autorem, poněvadž byl/je leaderem projektu RESTEasy od JBossu, což je certifikovaná implementace JAX-RS.

Co se týká knihy, můžu ji doporučit. Je dobře napsaná, Bill nijak netlačí svoje RESTEasy, ale objektivně zmiňuje i další alternativy - referenční implementaci Jersey a Apache CXF. Mě osobně trochu mrzelo, že celá druhá polovina knihy je workbook, jakýsi guide k příkladovému projektu - přece jenom, jak se pohybuju v architektonických sférách, tak to pro mne není až tak přínosný. Nicméně někomu jinému může tato "konrétně implementační" část pomoci dostat se (rychleji) do problému.

Ohledně RESTu jsem byl, až do přečtení knihy, panensky nepoznamenán. Teoreticky již nyní mám načteno (i z jiných zdrojů), ovšem RESTový projekt, který by mne pokřtil ohněm, mě teprve čeká. (To že jsem jednou restovou architekturu navrhl v nabídce, se nepočítá) V tomto postu (aby mi něco z toho v hlavě zůstalo) bych se zaměřil na to, co pro mne bylo nejpřínosnější a nejzajímavější: zcela jednoznačně to jsou architektonické principy RESTu.

Že termín representational state transfer pochází z dizertačky Roye Fieldinga (2000), bylo na webu napsáno již milionkrát, takže to tady nebudu omílat a skočím rovnou rovnýma nohama do principů, na kterých stojí.

Adresovatelnost

Celý REST se točí kolem zdrojů (resources). Každý takový zdroj by měl být dosažitelný pomocí jedinečného identifikátoru (URI). Tohle je celkem jednoznačný u dokumentů, aplikací a služeb. Ale když vezmeme v potaz např. Java objekty deployované na aplikačním serveru, tak u nich chybí jednotný/jednoznačný způsob identifikace, který se navíc bude lišit podle různých implementací/dodavatelů (např. JNDI).

Pro identifikaci zdroje se používá URI, které má standardizovanou podobu:

  • scheme://host:port/path?queryString#fragment

přičemž scheme je protokol (např. HTTP), host je DNS nebo IP adresa, port je... port, path je virtuální hierarchická struktura, queryString je množina párů klíč=hodnota, oddělených znakem & a fragment je identifikátor, který označuje nějakou část zdroje (např. nadpis nebo obrázek v dokumentu).

Jednotné rozhraní

Tak jako se REST točí kolem zdrojů, tak se také točí kolem HTTP, jehož jednotlivý metodám připisuje specifický účel a význam.

  • GET je určena pro read-only operace, jako je načtení seznamu zdrojů (dokumentů), nebo obsahu jednoho zdroje. Je jednak idempotentní (lze ji volat opakovaně se stále stejným výsledkem) a jednak bezpečná (safe, nezpůsobuje žádné vedlejší efekty).
  • PUT umožní daný resource (tělo zprávy/requestu) uložit na serveru na určitém URL. Předpokládá, že klient zná potřebný identifikátor. Metoda je idempotentní, technicky bývá implementovaná jako insert nebo update.
  • DELETE odstraní daný resource. Je idempotentní.
  • POST je funkčně hodně podobná metodě PUT. Zásadní rozdíl je, že je to jediná metoda která není idemopotentní. Čili s každým dalším requestem měním stav daného zdroje/služby.
  • HEAD je podobná metodě GET, s tím rozdílem, že response nevrací body, ale pouze response code a HTTP hlavičky.
  • OPTIONS vrací komunikační možnosti a schopnosti serveru pro dané URI.

Orientace na reprezentaci

Při komunikaci pomocí HTTP metod dostáváme a posíláme na dané URI nějakou reprezentaci zdroje. Podle toho, čím je daný zdroj reprezentován, tak dostáváme/posíláme XML, JSON, YAML apod.

Metodou GET například můžu z nějakého URI dostat takovouto reprezentaci:
<product id="42">
    <name>Kindle Touch</name>
    <currency>USD</currency>
    <price>139</price>
</product>
Pokud bych chtěl zdroj na serveru změnit, pak pošlu metodou PUT (nebo POST) na stejné URI následující reprezentaci (změna ceny):
<product id="42">
    <name>Kindle Touch</name>
    <currency>USD</currency>
    <price>99</price>
</product>
Jestli bych použil PUT nebo POST, by záleželo na designu této služby. Obecně, protože PUT je, podle definice, idempotentní, tak se používá pro update, POST idempotentní není a používá se pro insert.

Nebo jinak definováno - s prvním PUT requestem se založí na serveru zdroj a s každým dalším stejným PUT requestem se tento zdroj aktualizuje. Pokud request obsahuje stejná data, zdroj se nijak nemění (to je ta idempotentnost). Naopak s každým POST requestem by měl na serveru vždy vzniknout nový zdroj. To v reálu často nebývá pravda - POST funguje jako update (stále stejného zdroje), což ale není čistý RESTový design.

Bezstavová komunikace

Bezstavovost znamená, že žádná klientská data nejsou spravována na serveru, tzn. žádná klientská session. Pokud aplikace potřebuje udržovat stavovost, spravuje si ji sama (jako kdyby to byl tlustý klient) a pouze propaguje na server změněné zdroje.

Mezi běžně uváděné benefity bezstavovosti patří: jednoduchost business logiky, škálovatelnost a cacheování resourců.

HATEOAS

Význam této ošklivé zkratky je Hypermedia As The Engine Of Application State. S pochopením tohoto principu jsem měl největší problém. Myšlenka je jednoduchá - datový formát, hypermedia (rošíření hypertextu), poskytuje speciální informaci, jak měnit stav zdroje. A dotaženo do konce - klient by měl komunikovat se serverem pouze pomocí hypermedia a nepotřebuje k tomu žádnou další (technologickou) informaci.

V případě webových služeb je HATEOAS přítomen v podobě odkazů uvnitř (XML/JSON) dokumentů, které představují zdroje. U XML dokumentů se pro odkazy často používá specifikace Atom a z ní konkrétně element link.
<product id="42">
    <link rel="self"
          href="http://amazon.com/product/42"
          type="application/xml"/>
    <link rel="payment"
          href="http://amazon.com/checkout/42"
          type="application/xml"/>
    <name>Kindle Touch</name>
    <currency>USD</currency>
    <price>139</price>
</product>
Jak pojmenovávat jednotlivé relace uvnitř odkazů je částečně standardizováno, takže se používají např. následující (samopopisná) jména: chapter, edit, first, icon, last, next, payment, previous, self, stylesheet ad.

Zamyšlení

Musím přiznat, že v rámci teoretického načtení, se mi RESTová architektura hodně líbí, zejména svojí čistotou a jednoduchostí. Je otázka (času), jak se tento můj pohled změní při použití RESTu v praxi. Tu praxi, bohužel, zatím vidím na nějaký menší projektík, protože jak se poslední dobou věnuju SOA v enterprise sféře, tak musím konstatovat, že REST je v této oblasti opomíjen jak dodavateli řešení, tak zákazníky. Ale snad se časem začne blýskat na lepší časy.

22. září 2012

Management za zavřenými dveřmi

Když mám problém, sáhnu po knize. Samozřejmě, chytrá kniha sama o sobě nestačí. Ale pro mne je to dobrý odrazový bod, jak se zorientovat v neznámých vodách. Plavat už člověk musí sám.

Když se řeší technologické věci, bývá to většinou jednoduché, často zábavné, někdy frustrující. Když se řeší problémy s lidmi, bývá to většinou složité, často frustrující a hlavně - nejednoznačné.

Problém podobný tomu aktuálnímu jsem řešil cca před rokem - přišel jsem jako team leader do týmu vývojářů. Tým nebyl zrovna vstřícně naladěn, někteří členové byli až nepřátelští. Protože jsem podobnou situaci zatím nikdy neřešil, koupil jsem si tematickou knihu (viz post (Ne)funkční tým) a zkusil jsem se s tím (z dnešního pohledu bych řekl, že neúspěšně) poprat.

Nevstoupíš dvakrát do téže řeky. Takže po roce: stejná role (teamleader), jiný tým (nesrovnatelně pozitivněji naladěn), podobný projekt (integrace na middlewaru) a úplně jiný problém. To si vám takhle týmlídruju, v týmu mám pět lidí, 50 % času věnuju řízení (takový ty JIRY, statusy a tak), 50 % věnuju vývoji. Radost pracovat. (Pozor, teď přijde zápletka.) Najednou: BUM, PRÁSK! Tým se ztrojnásobí! Nekecám, 16 lidí?!? Navíc, byť to téměř všichni byli seniorní javisti, z hlediska použité technologie a architektury (SOA), byli v podstatě juniorní a náběhová a učící křivka byla velmi dlouhá (2 měsíce).

Šestnáct lidí je opravdu hodně. Maximum, co mám teoreticky a empiricky ověřeno, je deset a člověku to zabere 100 % času. Na nějaké kódování může zcela zapomenout. Šestnáct lidí, to už není teamleading, to už je čistý management. Ehm. Já, excelentní vývojář ;-) a management? Jak říkám: když mám problém, sáhnu po knize.

Vybral jsem si titul Behind Closed Door, jejíž podtitul slibuje odhalit Secrets of Great Management. Nevím, jestli se dodržováním principů uvedených v knize, stane člověk skvělým manažerem. Ale to ani nebyl můj cíl. Chtěl jsem si jen ověřit, že některé věci dělám správně, že v dobré víře nedělám chyby a taky si trochu rozšířit repertoár.

Ostřílení matadoři by asi nad radami v knize mávli rukou, že to není nic nového, je to samozřejmost atd. Ano, ony to opravdu jsou jednoduché věci. Ale to asi nejtěžší na tom je, být konzistentní a perzistentní :-)

Kniha používá osvědčený formát - fiktivní příběh fiktivního manažera (který přijde nově do společnosti, vyřeší všechny problémy a všichni jsou šťastný a firma vydělá balík), prokládaný konkrétními tipy a postupy jak danou věc dělat/řešit. V průběhu příběhu jsou postupně probírána témata jako: delegování, prioritizace, zpětná vazba, koučování, one-on-one pohovory, prosazování vlivu apod.

Pro mne byly z knihy nejpřínosnější dvě témata. Jednak jsem se utvrdil v tom, že je důležité dělat one-on-one pohovory a držet je pravidelně. Už nějaký čas je dělám ve všech týmech a myslím, že to je jedna z věcí, která velmi podstatně zvedne důvěru v týmu. A důvěra to je základ, na kterém je dobrý tým postaven.

Druhým podstatným tématem pro mne byla zpětná vazba a přesněji korektivní zpětná vazba. Možná to znáte - lidi v týmu pracují většinou dobře, ale jeden/dva z nich podávají slabší výkon. Je to delikátní situace, vždycky je tu nějaký důvod, proč tomu tak je. Pokud má člověk zájem (a je mu to důstojně podáno), často se dají překážky, které brání kvalitní práci odstranit. V knize je popsáno, na co si dát pozor, aby se komunikace nepřeklopila do iracionální roviny. A taky, kdy to už nemá smysl řešit.

Komu bych knihu doporučil? Určitě začínajícím teamleaderům. Byť není zaměřena na technické vedení lidí a projektů se dotýká jen zlehka, je to dobrý začátek, protože jako teamleader budete komunikovat primárně se svým týmem a sekundárně s projektem a jinými týmy. Doporučil bych ji i pokud máte, tak jako já, nějakou tu teamleaderovskou zkušenost za sebou. Vždycky je totiž něco nového, co se dá naučit a stávající zlepšit. Třetím doporučením je pak edice, v které  knížka vyšla - vydavatelství The Pragmatic Programmers je zárokou kvalitní softwarová literatury a mne nezklamala ani tentokrát.

No a jak se vyvinul můj v úvodu zmíněný problém? Tým se mezitím stabilizoval a taky se smrsknul na rozumnou úroveň deseti lidí. Držím pravidelné one-on-one pohovory jednou za měsíc. V jednom případě jsem si vyzkoušel korektivní zpětnou vazbu s následným dohledem, což nakonec, bohužel, vyústilo v odchod daného člověka z týmu. Taky jsem, s těžkým srdcem, musel delegovat několik Proof of Concept, na který jsem se moc těšil. Tak snad to aspoň pomohlo někomu jinému. Je toho samozřejmě daleko víc, co dělám (a co je potřeba dělat), aby jsme měli dobrý tým. Uvedl jsem pouze věci, které přímo souvisí a jsou tématy představené knihy.