Zobrazují se příspěvky se štítkemsw engineering. Zobrazit všechny příspěvky

19. září 2017

Střípky z prototypování II: WebSockets

V úvodním díle jsme se dívali na jednoduchý prototyp - jak spojit dvě etablované webové technologie: Wicket a Spring. Bylo to takové zahřívací kolo, ještě o nic nešlo. Spíše o to, připravit si prototypovací platformu, než vyřešit zapeklitý technický problém.

V dnešním díle se podíváme na prototyp, jehož negativním výsledkem mohla být výměna GUI technologie, což by vedlo k refaktoringu cca 1/3 aplikace.

Kontext

πάντα χωρεῖ καὶ οὐδὲν μένει ~ Ἡράκλειτος
Jak říká Hérakleitos z Efesu: "všechno se mění a nic nezůstává stejné". To se tak stane, že zákazníkovi prodáte určité řešení. Všude - v odpovědi na RFQ, v kontraktu, na workshopech se zákazníkem - prezentujete, že GUI určité aplikace bude "wizard-like".

Vyberete technologie, nastřelíte aplikační prototyp a začnete vyvíjet business features. Vývojáři studují a postupně si osvojují nové technologie. Svět je krásný...

A pak přijde UX designer a hodí vám do toho vidle. Řekne, že uživatelé milují skrolování a cool, že jsou Single Page Aplications (SPA). A vy si uvědomíte, že GUI technologie, kterou jste zodpovědně vybrali (možná i nějaká bezesná noc tam byla), se se změnou paradigmatu není schopná vyrovnat.

Use Case

Cíl tohoto prototypu byl přímočarý: zpropagovat data, která přijdou na server z bezstavové RESTové služby do prohlížeče konkrétního uživatele a překreslit určitou část obrazovky, aby se tato data zobrazila. S nadsázkou jsem tomu říkal: přidat "reactive-like" chování.

Podmínkou samozřejmě bylo, aby zůstaly zachovány stávající technologie (tedy Spring a Wicket). Pro úplnost dodám, že Wicketovské komponenty jsou vždy stavové.


Implementace

Implementaci jde rozdělit do dvou kroků:
  1. Zpracování RESTového volání a propagaci dat do Wicket komponenty na serveru.
  2. Push dat ze serveru do konkrétního prohlížeče.

Observable Cache

První bod můžeme realizovat pomocí Observer patternu - do řešení přidáme další element, který zatím budeme nazývat observable cache (a více si o něm povíme v příštím díle). Observable cache nám bude fungovat jako synchronizační mechanizsmus:
  1. Wicket komponent se zarigistruje jako observer do observable cache.
  2. REST kontroler vloží data do observable cache.
  3. Observable cache notifikuje zaregistrované observery (wicket komponenty).


Jelikož observable cache je pro nás zatím abstraktní komponent, jehož technologie/implementace bude vybrána později (a navíc pro nás momentálně není podstatná), vytvoříme si ji pro začátek jako jednoduchou observable HashMapu. Pro začátek budeme chtít notifikace pro metody put a remove.


Následně zaregistrujeme Wicket komponentu (Panel) jako observera. Potřebná WebSocket logika půjde do metody update(). Prozatím ji necháme prázdnou, než probereme, jak se Wicket staví k WebSocketům.


Wicket a WebSockety

Je to taková matrjoška. Existuje WebSocket specifikace. Ta je implementována Java API for WebSocket (JSR 356). A Java API je pak obaleno Wicktovskou implementací/rozšířením. Wicketovská dokumentace je popsaná v referenční příručce v kapitole Native WebSockets. Některá témata zde chybí, ale je to dobrý začátek.

To, co Wicket k WebSocketům přidává a co také využijeme pro náš případ (a co také chybí v dokumentaci), je "broadcastování" WebSocket zpráv. V základě to umožňuje poslat WebSocket událost všem komponentům, které mají definované WebSocketBehavior. Komponent pak může přijatou událost dále filtrovat a rozhodnout se, jestli na ni reagovat.

To, že náše aplikace bude WebSocket-ready, nám zajistí náhrada klasického WicketFiltru za JavaxWebSocketFilter:


Tady trochu odbočím od WebSocketů k servletům. Aby WebSockety fungovaly, musí je podporovat servlet kontejner, ve kterém aplikace poběží (všechny moderní kontejnery by to měly umět).

V rámci popisovaných prototypů probíhá deployment jako součást buildu, do embedovaného servlet kontejneru, který nám poskytuje výborný Gradle plugin Gretty (k dispozici jsou Jetty a Tomcat). Bohužel, našel jsem tady pravděpodobně bug - WebSockety nefungují v embedovaném Jetty, takže je potřeba používat embedovaný Tomcat. (Ve standalone Jetty funguje všechno jak má, takže to bude problém Gretty.)

Zpátky k WebSocketům a Wicketu. Nyní, po notifikaci z observable cache, chceme z metody update broadcastovat WebSocketEvent a opět ji odchytit ve Wicket panelu, který budeme chtít překreslit. Data pro model komponentu si vytáhneme přímo z cache.


Pokud se podíváme na tento proces z hlediska kódu, potřebujeme ve Wicket komponentu aktualizovat pár věcí:
  1. V konstruktoru přidat na komponentu WebSocketBehavior.
  2. Z metody update broadcastovat IWebSocketPushMessage.
  3. V metodě onEvent zprávu přefiltrovat.
  4. Nechat komponent (nebo jeho část) překreslit.
  5. V rámci překreslení dojde ke znovu-načtení modelu.


Prototype repozitory

Pokud si budete chtít prototyp spustit a trochu si s ním pohrát, naklonujte si následující Bitbucket repository. Součástí prototypu je SoapUI projekt, s připraveným REST requestem, kterým si můžete poslat data do prohlížeče.

Klíčové třídy:

Poučení

Občas se ukáže, že řešení, které jsme odkládali jako nejzažší možné, je nakonec to správné. Nebo jediné funkční. Je potřeba zvážit potenciální důsledky - např. přepisování GUI vrstvy versus pozdější perfomance problémy (kolik WebSocket spojení bude v produkci otevřených? Jaký bude objem broadcastovaných zpráv? apod.)

Zvolili jsme na počátku dostatečně flexibilní technologii, aby uspokojila i nároky v úvodu zmiňovaného Hérakleita z Efesu? (Eh, chtěl jsem říci šíleného UX designera.) Malý, rychlý prototyp může dát na tyto otázky odpověď. Nebo aspoň vyznačit cestu, kudy ne.

Příště

V pokračování střípků se podíváme na to, čím nahradit observable cache. Můžete se těšit na sebevražedný deathmatch Neo4j vs. Infinispan.

Repository všech prototypů


Související články


22. srpna 2017

Střípky z prototypování: Wicket, Spring, REST

Měl jsem to štěstí, že jsem se teď mohl několik týdnů věnovat prototypování. Štěstí, protože je to jeden z mých nejoblíbenějších aspektů softwarového inženýrství.

Všechny prototypy vedly k cílovému, zbrusu novému řešení. V kontextu naší firmy, by to normálně dělalo oddělení R&D, ale z kapacitních a projektových důvodů to skončilo v našem delivery týmu. Rád jsem se toho ujal.

Vzhledem k tomu, že by popis řešení a implementace zabraly mnoho článků, rozhodl jsem se vytáhnout jen několik zajímavějších fragmentů z následujících témat (a i ty rozdělím do dvou-tří zápisů):
  • REST contract-first
  • Wicket + Spring
  • Wicket + REST via Spring
  • WebSockets
  • Embedded Neo4j
  • Embedded Infinispan

REST contract-first

O tomhle tématu už jsem psal v článku REST contract-first: Swagger & Gradle. Zmiňuju ho pro úplnost, ať je to na jednom místě a také protože vychází ze stejného konceptu prototypu, jako všechny následující.

Wicket + Spring

Use case

Na počátku bylo slovo: udělejte novou aplikaci. Technologie nikdo neřešil - po pravdě, existovalo rozlehlé architektonické vakuum. Tak jsem se do toho vložil a na základě tehdejších informací a kontextu jsem vybral dvě technologie: Wicket na webové GUI a Spring na "všechno ostatní".

"Všechno ostatní" zde znamená:
  • REST služby a klienti
  • Business logika
  • (Potenciálně) persistence
  • (Finálně) security

Implementace

Wicket má se Springem dobré vztahy už po léta... i když, vo-cuď-pocuď. Zkrátka, bývávalo, že jste si ze Springu vzali jen to co potřebujete. Kdepak, už je to pěkně nenažraný cvalík, který si pozve spoustu bratříčků. A skloubit ho s něčím specifickým... je docela práce.

Nicméně. Způsob, jak propojit Wicket a Spring je dvojí - jde o to, kdo koho instancuje. První způsob - kdy Wicket instancuje Springovský kontext, ze kterého je potom možné injektovat do Wicketovských komponent přes anotaci @SpringBean - je dobře popsaný ve Wicketovské Reference Guide: Integration Wicket with Spring.

Druhý způsob je flexibilnější, avšak, není nikde moc zdokumentovaný a když už, tak jen pomocí konfigurace web.xml. Funguje to tak, že WicketFilter instancuje SpringWebApplicationFactory, která prohledá Springovský kontext a instancuje Wicketovskou WebApplication. Výhodou je, že se dá injektovat přímo do Wicket aplikace, což u předešlého způsobu nejde.

Pokud chceme oželet web.xml (ano, prosím!), vypadá konfigurace filtru takto:


Prozatím pomiňme, že filter rozšiřuje JavaxWebSocketFilter (viz sekce WebSockets), obyčejný WicketFilter postačí také.

Prototype repozitory


Pokud vám to neštymuje dohromady, klíčové jsou 3 třídy:

Poučení

Tady se žádné velké překvapení nekoná - funguje to stejně dobře, jako když jsem s Wicketem a Springem pracoval před osmi lety poprvé, jen se nám oba frameworky mocně posunuly ve verzích. Snad jen, že na takovém malém prototypu se jednoduše nacvičí přepnutí z jednoho typu instancování na druhý.

Wicket + REST via Spring

Use case

Spring a Wicket nám teď pěkně kohabitují. Ale chceme přidat RESTové služby - v současnosti všudypřítomná a triviální záležitost. Ne tak docela.

Spring nabízí REST buď v rámci Spring MVC, nebo Spring Boot. Přiznám se, tady mne dost zaskočilo, že Spring nenabízí RESTové služby samostatně, podobně jako ty SOAPovské (Spring WS). Nejsem expert na Spring, takže mi nejspíš něco schází, ale zatím to vidím, že dostává na frak buď modularita, nebo snadnost použití. Přitom jediný, co vlastně potřebuji je DispatcherServlet.

K tomu use casu - potřeboval jsem dedikované URL pro REST, které by neobsluhoval Wicket a zpracovávat/produkovat JSON zprávy.

Implementace

Řešení přišlo ve dvou krocích - zaregistrovat DispatcherServlet a podstrčit JSON mapování (z nějakého důvodu to Spring nedělá out-of-the-box). Dobral jsem se k řešení, které je sice funkční, ale rozhodně ne elegantní a možná i špatný design. (Zde bych byl vděčný za jakékoliv navedení na "správnou cestu".)

Zaregistrova DispatcherServlet jen tak přes @WebServlet annotaci mi nešlo - lítaly z toho tuny výjimek, protože ve Springovském kontextu chybělo spousty věcí ze Spring webové aplikace. Všechno to, co vám tam přidá anotace @EnableWebMvc. Tudy cesta nevedla.

Vyřešil jsem to dynamickým zaregistrováním servletu přes ServletRegistration, když jsem si přes Wicket vytáhnul ServletContext:


Druhý problém - přesvědčit Spring, aby chroustal JSON - mám vyřešený jen zpola: sice "zázračně" zafungovalo angažování komba AnnotationMethodHandlerAdapter a MappingJackson2HttpMessageConverter. Bohužel, je první třída @deprecated a to já nesnáším (pokudn není zbytí).

Spring doporučuje migrovat na RequestMappingHandlerAdapter, jenže k tomu chybí jakákoliv dokumentace a Google mlčí. Moje otázka na StackOverflow je také bez odpovědi.

Řešení, na které nejsem hrdý (účel světí prostředky):


Prototype repozitory


Klíčové třídy:

Poučení

Spring je fajn. Ale přijde mi po těch letech, že je míň flexibilní a narostl do stejného molocha jako Java EE. Pokud potřebujete něco specifického, budete se brodit Springovskými výjimkami a zoufale prohledávat StackOverflow. Mimochodem, další moje StackOverflow otázka o Springu je také nezodpovězena.

Říkám si, jestli to za to stojí, se přehrabovat tak hluboko ve vnitřnostech Springu, aby člověk implementoval relativně jednoduché věci. Trochu mi to zavání vendor lock-in: dobře si rozmyslet, jestli stavět heterogenní aplikaci, nebo použít homogenní Spring.

Příště

V pokračování střípků se podíváme na WebSockety a jak do "standardní" webové aplikace přidat "reactive-like" chování.

Repository všech prototypů


Související články


27. února 2017

Programátor -> Vývojář -> Software Engineer

Source: Wikipedia
Jak léta jdou, přemýšlím kontinuálně o cestě, kterou jsem urazil a kam směřuju. Jeden takový pohled na část takové cesty naznačuje titulek.

Dneska už jsem na té cestě dál - jsem v bodě, kdy už pár let "stavím" týmy. A byť nehledám lidi, kteří jsou mým odrazem - naopak, mám rád diverzitu a plánovaně, podvratně :-) ji aplikuju - podvědomě vybírám lidi, kteří na podobnou cestu aspirují a berou ji jako součást týmové kultury.

Téma je pro mě zajímavé - jak čistě myšlenkově, tak i prakticky. Pokud pracujete s týmy, tak kromě těch technických věcí, řešíte taky záležitosti jako rozvoj lidí, jejich vzrůstající finanční očekávání, ohodnocení jejich technické a jiné seniority atd.

Zároveň nebudu skrývat, že ne vždy se to podaří - přesvědčit, inspirovat lidi, že tohle je ta správná cesta. Občas vidíte potenciál, ale nepovede se vám dostat daného člověka z jeho bubliny. A někdy se prostě jen mýlíte a chybujete.

Korintským

Asociace, která mi naskočila, když jsem začal o tématu přemýšlet, pochází, možná překvapivě, z Bible - Pavlova listu Korintským. Je to taková ta pasáž, co se čte vždycky na svatbách... ale nebojte, nebudu vás zahrnovat láskou ;-) mám na mysli jinou větu:

Dokud jsem byl dítě, mluvil jsem jako dítě, myslel jsem jako dítě, měl jsem dětské názory; když jsem však dospěl, s dětinskými věcmi jsem se rozloučil. — 1. Korintským 13:11

Co mně přijde podstatné na tomhle citátu, je ten přechod - opuštění určité formativní fáze a přechod do další. A i když s tím občas bývají problémy, nejde o odvrhnutí předešlé fáze, naopak, ta by měla být integrována.

(A jen pro jistotu, protože vím, jak jsou lidi chytlavý - výběrem citátu jsem nechtěl říct, že – obecně – třeba programátoři jsou dětinští. Jasně, že občas jsou, ale není to generalizace. Ale což, ať si každý odnese, co potřebuje.)

Model

Jednoduchý model, který popisuje naše téma, vypadá jako tři soustředné kruhy. A tak jako cibule, krystal, či perla, rostou postupně schopnosti našeho hypotetického programátora.

Skill model

Programátor

Znáte termín code monkey? Je to většinou nelichotivý termín, i když občas se k němu někdo hrdě hlásí (většinou nápisem na tričku). Mě se líbí definice z Urban Dictionary, která dobře vystihuje, co si pod termínem programátor představuju já:

"A programmer who isn't actually involved in any aspect of conceptual or design work, but simply writes code to specifications given."

Programátor je pro mne člověk, který - s ohledem na svou senioritu - dobře rozumí úzce vymezené technické oblasti. Hranice je zpravidla definována daným programovacím jazykem a v dnešní době také stále více nějakým přidruženým frameworkem. Cokoliv za algoritmy, technickými aspekty jazyka a lokální kompilací (je-li potřeba), je mimo oblast zájmu a zodpovědnosti programátora - jeho práce končí komitem do verzovacího systému.

Taková úzce vymezená specializace nemusí být na škodu - záleží, jaká je vaše doména, role v týmu, rozsah projektu ad. Na druhou stranu, moderní softwarový vývoj vyžaduje daleko komplexnější spektrum schopností a mít v týmu "pouhého" programátora pak často znamená více zatížit ostatní členy týmu a  přenést na ně část činností, jež u programátora "padají pod stůl".

Vývojář

Vývojář je už o úroveň dál. Že dobře rozumí svému programovacímu jazyku, je samozřejmost. Stejně tak dobře ovladá sadu souvisejících knihoven a frameworků, jež tvoří jeho technickou doménu.

Jako velmi volný příklad si představme mlhavý termín Backend Developer. Umí asi nějakou "business logiku", řekněme v případě Javy někdo s CDI/EJB, nebo Spring+AOP+Transakce, plus nějakou tu persistenci, tudíž JPA/Hibernate/MyBatis/JDBC. A trošku té security.

Takže to je samozřejmost. Ale je to ještě něco navíc - větší, či menší povědomí, jak to spolu souvisí, nejen interně, ale i za hranice toho "backendu". Plus troška "toho designu" a zase - jak na úrovni kódu, tak na úrovni komponent.

No a pak... pozvolné přibližování se k oblasti SW inženýrství: vědět něco o buildování, možná i nějaký ten release management, něco praxe a teorie testování (aspoň unit a functional), source code management, issue tracking, atd.

To hlavní, co odděluje vývojáře od programátora? Schopnost vidět v technické oblasti "big picture".

Software Engineer

A co SW inženýr? Ovšem, je to dobrý vývojář. Ale ovládá také většinu souvisejících oblastí, potřebných pro kvalitní a moderní vývoj softwaru:

Ale v první řadě - a to už je moje velmi subjektivní spekulace - rozumí byznisově tomu, proč daný úkol dělá a proč ho dělá daným způsobem (což je, vzhledem k mé zkušenosti, velmi, velmi vzácné). Přece jenom, je to inženýr a jeho prvotním úkolem je řešit problémy. Reálné problémy.

Jediná cesta?

Na internetu a v knihách se vedou dlouhé diskuze, co je a co není SW inženýrství, ba, jestli vůbec něco jako SW inženýrství existuje. Moje zkušenost je, že na každém projektu je potřeba vždy a znova vybudovat terminologii. Význam a kontext konkrétního termínu se neustále proměňuje a podstatné je, abyste si s kolegy v týmu rozuměli.

Pro mne je software inženýr období a stav, kam jsem se dostal po téměř 20 letech programování. Šel jsem po výše naznačené cestě. Ta vaše bude zcela určitě jiná. O cestě, co jste urazili můžete vyprávět, ale zkušenosti jsou jenom vaše.

Je to realistické?

Samozřejmě, život není o zjednodušujících modelech a ideálních okolnostech. Skutečný svět je špinavý, divoký a ne-soustředný. V realitě tak vidíme spoustu prolínání vyše řečených rolí, jež se častokrát mění v čase i v rámci krátkého období, jako je třeba iterace, nebo projekt. A pak, existuje spoustu odlišností, jež nejsou výjimkami, ale spíše úplně jinými koncepty a přístupy. Diverzita života se mi vždycky líbila.

4. října 2016

Software Engineering, má rozumné paralely?

Konstantou Software Engineeringu (SE) je jeho dynamika. Snad právě proto hledáme paralely a podobenství v jiných oblastech lidské činnosti - abychom lépe porozuměli jeho zákonitostem, uchopili jeho abstraktní nehmotnost a někdy ;-)  i jen našli pevnou půdu pod nohoma.

Nejčastějšími doménami, kam se sahá pro inspiraci a popis jsou: "klasická" architektura a stavebnictví (stavíme sofware), strojní výroba (vyrábíme software) a automobilový průmysl (procesní a automatizovaná výroba od designu po prodej). Tyto paralely jsou hodnotné, protože umožňují průmět, projekci něčeho obecně známého do něčeho, o čem někdy tušíme pouze fuzzy obrysy.

Auta, domy, nebo továrny?

Tak jak jsou tyto paralely přínosné, tak jsou zároveň zavádějící. Což není nijak překvapivé - architektura má za sebou tisíce let vývoje. První automobil vznikl někdy v 19. století. Pokud bychom tedy chtěli srovnávat softwarový vývoj s automobilovým průmyslem, bylo by adekvátnější, kdybychom to dělali s fází, kdy ještě nebyl průmyslem. Tedy v dobách, kdy byly zhruba jasné požadavky, ale každý je implementoval po svém.

Automobil Benz z r. 1885 (zdroj Wikepedia)

Tehdy ještě nebyla žádná standardizace. Postupně vznikala unifikace, normy, automatizace, globalizace. Tyhle tendence lze také vysledovat i v oblasti SE. Ale pořád to každý dělá tak nějak po svém.

Pokud máme k dispozici standardizované komponenty (třeba cihly), lze z nich skládat komplexní řešení. Ale nejen to - dá se také přesně spočítat (s rozumnou odchylkou) koncová cena, v návrhu se dají zohlednit jejich fyzické vlastnosti (např. stabilita cílového řešení) atd. Tohle všecno v SE chybí.

Marnost, samá marnost

Lidé z byznysu už dlouhá léta sní o tom, jak se bude software skládat z jednotlivých "krabiček" (= komponent), ale kromě marketérů, kteří se snaží taková řešení prodat, nejspíš nikdo nevěří tomu, že by to fungovalo.

Z mojí zkušenosti se nejdál v tomto směru dostaly nástroje a systémy z oblasti SOA (a nijak překvapivě, hlavně ty komerční). Do určíté úrovně (abstrakce, či návrhu) lze řešení vytvářet "taháním kostiček a šipek". Ovšem od této hranice níž nastává, námi vývojáři běžně zažívaná, realita - ty "kostičky" je potřeba naimplementovat a to už jsme na poli klasického softwarového vývoje.

Kompozitní aplikace v Oracle SOA Suite (zdroj Oracle)

Samozřejmě, hodně by zde pomohla znovupoužitelnost. Ale ruku na srdce - už jste někdy viděli, že by reusabilita fungovala na úrovni komponent? Já teda moc ne. Obvykle bývá problém v governance - dozvíte se, že to není pořeba, není to ve scopu projektu, verzování je zbytečná práce navíc, řešení (zpětné) kompatibility je moc náročné atd. Takže řekněme, že... znovupoužitelnost je hezký, ale teoretický koncept. Zatím. Oni se to lidi časem naučí. Tak jako se naučili stavět domy a auta.

Jiným problémem SE je, že se nezabývá jednou (byť třeba rozsáhlou) doménou, jako třeba stavebnictví, ale zasahuje v podstatě do jakékoliv oblasti. V takovém prostředí se pak velmi těžko extrahují nějaké principy, o které se lze opřít v příštích projektech. Proč asi agilní vývoj neslibuje nic konkrétního, ale spíš něco ve stylu "bude to kvalitní, budeme to neustále zlepšovat, ale nevíme přesně, co to nakonec bude" :-)

Vanitas vanitatum. Byť se někteří z nás věnují SE celý svůj produktivní život a pokud zůstanou zdravými programátory, tak snad i zbytek života; tak z hlediska pomíjivosti je SE stále ještě v dětských letech (ne-li v plenkách). Třeba se za sto let naši potomci a následovníci ohlédnou zpět a budou nás litovat, v jakých krutých a nestabilních podmínkách jsme budovali svá díla. A po dalších staletích, až vznikne nové vědecké odvětví - softwarová archeologie - budou vzdálené generace stát v úžasu nad tím, co jsme dokázali vytvořit holýma rukama. (Anebo taky ne.)

Má to smysl?

Pokud se kruhem vrátím zpátky na začátek - má smysl hledat pro SE nějaké paralely? Myslím si, že ano. Pomůžou s porozumněním komplexních řešení a problémů, na které lidská mysl není designovaná. Ale je potřeba to brát s rezervou... software zkrátka nemá čtyři kola.

Související externí články


26. srpna 2014

Mercurial, strategie branch-by-feature


Mercurial je skvělý, distribuovaný Version Control System (VCS, či DVCS), který nabízí velkou míru volnosti, jak s nakládat s verzováním zdrojových kódů. Svobodu většinou chápeme jako pozitivní věc, někdy je ale přílišná nespoutanost na škodu. A tak definování nějaké verzovací strategie prospěje týmu i projektu.

Proč mít verzovací strategii?

Verzovací strategii branch-by-feature jsme s úspěchem použili na stávajícím projektu. Důvody, proč jsme si něco takového definovali byly dva:
  • Když jsem se mihnul na předcházejícím projektu (taky Mercurial), žádná strategie, či konvence definovaná nebyla . Člověk pak slýchal řeči jako: "Proč to furt merguješ?", "Vznikaj ti tam anonymní branche." a "Tam by's měl používat rebase.". Prostě klasický, tohle-tady-všichni-ví a takhle-to-děláme-ale-tobě-jsme-to-neřekli.
  • Chtěli jsme mít na nadcházejícím projektu formalizované code review.

Takže jsme se zamysleli, chvilku nad tím špekulovali a pak jsme, spolu s podporou dalších nástrojů, došli k následující strategii.

Strategie branch-by-feature

Princip téhle strategie je jednoduchý a dá se popsat jednou větou: Pro každou novou feature (nebo bug) se založí nový branch. Hotovo, vymalováno.

A teď trochu obšírněji. Na počátku je v repozitory pouze jeden permanentní branch. Zpravidla se mu říká development branch. Z něj se odlamují další branche pro vývoj - feature branche. Co přesně tyto branche představují, záleží na granularitě položek, do kterých jsme si práci rozdrobili. Může to být user story, feature, requirement, task. Ideálně je to něco, co evidujeme v issue tracking systému (ITS).

Probíhá běžný vývoj a všechny komity jdou do (odpovídajícího) feature branche. Když je vývoj hotový, proběhne code review a pokud jsou změny akceptovány, zamergují se do development branche a feature branch se zavře. Pokud jsou změny zamítnuty, provede se náprava, komitne se do feature branche, následuje code review atd.

Pokud jsou v této fázi nalezeny nějaké bugy, přistupujeme k nim stejně jako k feature. To jest, bug branch -> code review -> merge do development branche.

Verzovací strategie branch by feature

Po nějakém čase vznikne release branch. Pokud jsou v něm nalezeny chyby, vzniká bug branch a po code review přichází merge jak do release, tak do development branche.

Celý postup se dá shrnout do následujících bodů:
  1. Vytvoření nového feature/bug branche.
  2. Development.
  3. Změny projdou code review.
  4. Uzavření feature/bug branche.
  5. (Bugfixy jsou zamergovány do release branche.)
  6. Změny jsou zamergovány do development branche.

Z pohledu příkazové řádky vypadá proces takto:
$ hg branche fb-logging
$ hg commit -m 'Logging feat. has been developed.'
$ hg commit -m 'Close branch fb-logging.' --close-branch
$ hg update default
$ hg merge fb-logging
$ hg commit -m 'Merge branch fb-logging -> default.'

Zcela záměrně se vyhýbám popisu code review. To proto, abych nekradl materiál svému kolegovi Banterovi, který již jistě brzy napíše článek, o tom, jak to děláme (je to fakt cool, tak se těšte). Nicméně, ve vztahu k Mercurialu si nemůžu odpustit, jak to vypadá procesně. Přepokládám, že všichni čtete plynně BPMN ;-)  takže dalších slov netřeba. Mercurial aktivity jsou v oranžovém rámečku.

Code Review proces (oranžové jsou aktivity v Mercurialu, modré v RhodeCode)

Drobná a příjemná vylepšení

Což o to, proces, jako takový, je pěkný. Na někoho je ale možná trochu komplexní. Přece jenom, když mastíte celý život všechno jenom do trunku, může to být trochu moc věcí najednou. Tady je pár věcí, které nám to o něco usnadnili.

Konvence

Konvence jsme měli nastavené jednak pro názvy branchů a jednak pro komitovací komentáře. Název nového branche se skládal z prefixu a čísla issue v ITS. Prefix byl buď fb- (feature branch), nebo bb- (bug branch). Např. fb-42, bb-1024.

Konvence pro komentáře by se daly rozdělit do tří skupin: běžné komentáře, při zavírání branche a při vytváření releasu. Konvence samotná by se v Mercurialu dala pohlídat pomocí hooku, ale nedokopal jsem se k tomu, ho napsat. Pro "běžné", vývojové komentáře jsme měli konvenci WIP #nnn; some comment. WIP je zkratka pro Work In Progress, nnn je id issue v ITS. Např. WIP #1561; Payment button has been removed.

Zavření branche se skládá ze čtyř Mercurial příkazů (commit, update, merge, commit, viz výše) a obsahuje dva komentáře ve formátu:
  • Close branch <branch-name>.
  • Merge branch <branch-name> -> default.

Za zmínku stojí mergovací komentář, ze kterého by mělo být jasné, odkud kam merge proběhnul.

Komentáře při zavírání branche

Releasovací komentáře byly celkem čtyři a obsahovaly klíčové slovo [Release].

Komentáře při vytváření releasu

V předešlém popisu vás možná zarazilo, že jak pro zavření branche, tak pro vytvoření releasu je potřeba spustit čtyři Mercurial příkazy. Dělat to ručně by byla značná otrava a hlavně by celá konvence brzo erodovala do chaosu. Šťastni kdož používají automatizaci, neboť jen ti vejdou do křemíkového nebe.

Mercurial alias

S používáním aliasu přišel kolega Banter, takže mu za to patří dík a rád ho zde zvěčním. Alias samotný vypadá dost ošklivě, zato jeho použití je elegantní. Jedinou vadou na kráse je, že jsme nepřišli, jak alias spustit z grafických nástojů, jako je SourceTree, nebo TortoiseHg, takže ještě budeme muset zapracovat na tom, aby tuto fičurku mohli používat i kolegové, kteří ještě nepřišli na to, jak cool je používat command line ;-)

Alias stačí přidat do souboru ~/.hgrc a spouští se jednoduchým příkazem hg close-feature nnn, kde nnn je (v našem případě) čístlo issue v ITS, tj. to, co je za prefixem fb-.
[alias]
close-feature = ![ -z "$1" ] && echo "You didn't specify a branch!" && exit 1; \
                if hg branches | grep -q "fb-$1"; \
                    then $HG up fb-$1; \
                         $HG commit -m 'Close branch fb-$1.' --close-branch; \
                         $HG pull; \
                         $HG up default; \
                         $HG merge fb-$1; \
                         $HG commit -m 'Merge branch fb-$1 -> default.'; \
                    else echo "The branch fb-$1 does NOT exist!"; \
                fi

Gradle release task

Náš projekt buildujema Mavenem. Chvilku jsem se snažil napasovat Maven Release plugin na naši branchovací strategii, ale pořád to nějak nebylo ono - je to prostě moc šitý na SVN. Pak jsem ztratil trpělivost a odpovídající chování si napsal jako Gradle task. Časem se z toho snad vyklube Gradle plugin.

Task samotný tady uvádět nebudu, protože je asi tak na tři stránky. A taky potřebuje ještě trochu poladit. Zkrátka ještě není zralý na to, abych ho dal z ruky. V podstatě ale dělá pouze to, že přepíná branche, šolichá s Mercurialem a manipuluje s verzí v pom.xml. A dělá to ty hezké komentáře, co jsem uváděl výše.

Pros & Cons

Celý výše popsaný koncept jsme vymysleli ještě před projektem. Pak přišel projekt a emotivně musím říct, že nám to krásně fungovalo. Jako hlavní benefit vidím, že jsme si formalizovali proces code review a s výše uvedenou branchovací strategií to bylo velice efektivní. Dalším plusem byla, "úhledná" práce s Mercurialem, kdy byla radost se prohrabávat verzovanou historií.

K negativům bych zařadil komplexnost. Pokud by nám nešlo o code review, asi by tato strategie byla zbytečná. Zatím mi taky chybí nějaká podpora v grafických a automatizačních nástrojích. Jako milovníkovi CLI mi to osobně nijak nevadí, ale musím myslet taky na ostatní členy týmu (bývalý kolega jim říkal "makáči" :-)  pro které by mělo být používání nástrojů co nejsnadnější.

Je to všechno?

Abyste dostali plný obrázek, jak to celé fungovalo, chybí nám jeden velký dílek skládanky - jo, code review. Takže pokud vám něco nedává smysl, tak je to možná proto, že jsem v tomto článku celkem důsledně odpáral použití dalších dvou nástrojů, které byly s branchovací strategii organicky provázané - issue tracking system a RhodeCode, nástroj, ve kterém jsme, pomocí pull requestů, řešili code review.

Popis code review je na samostatný článek. Tak snad ho Banter brzo napíše a já sem pak lísknu odkaz. A jinak doufám, že vám zmiňovaná strategie branch-by-feature přijde inspirativní.

Happy branching! :-)

Mind Map


Související články

12. srpna 2014

Kanban, zprávy z fronty II

Máme za sebou, s týmem, další, úspěšnou implementaci Kanbanu. Projekt pomalu končí, je čas se ohlédnout. Jak to vypadalo, co fungovalo, co je potřeba zlepšit?

O projektu

Vzhledem k tomu, že z bezpečnostního hlediska se jedná o citlivé téma, nebudu psát nic o architektuře a technologiích. Což ale nevadí, protože z pohledu Kanbanu je obsah a typ projektu nepodstatný. Ale ať nám to povídání nevisí ve vzduchu, nastíním business case.

Výsledkem projektu je/bude webová aplikace, s jejíž pomocí si zájemci mohou online zažádat o různé typy víz a povolení (pracovní, k pobytu apod.) a také je eventuálně online zaplatit. Aplikace, jako taková, je velmi hloupoučká, veškerá business logika a workflow zpracování žádosti se děje na backendu, který už není součástí naší dodávky.

Team

Šlo o malý projekt, takže i malý tým - 2 vývojáři, 1-2 testeři/integrátoři, 1 technical leader, 1 project leader. Celkově (a konstantně během celého projektu) nějakých pět lidí. Pouze dva členové týmu měli předešlou zkušenost s agilním vývojem, s Kanbanem pak pouze jeden. Tým byl technicky seniorní, žádný junior.

Vizualize

Základním přikázáním Kanbanu je vizualizuj! Všechno, co jde (a dává smysl), vše, co dá lepší viditelnost projektu.

Kanban Board

První věc, která se (obvykle) vyzualizuje, je projektové/procesní workflow. Použili jsme jak fyzický, tak elektronický board. Ten elektronický byl založen na issue tracking (ITS) nástroji Redmine.

Bohužel, Redmine je, jako ITS, dosti nezralý/problematický a pro Kanban nemá žádný použitelný plugin. Problém jsme vyřešili "oklikou přes ruku" (= workaround) pomocí pluginu Wiki Lists, který dává přijatelný výsledek. Elektronický board byl primárním zdrojem informací a stavu.

Elektronický Kanban board (Redmine a Wiki Lists plugin)

Fyzický board byl druhotný zdroj informací. Používali jsme ho jako přirozené místo setkávání týmu (stand-upy). Další výhodou byla jeho neustálá přítomnost v open spacu. Takže všichni viděli :-)

Každý člen týmu byl zodpovědný za synchronizaci svých tasků mezi ITS a fyzickým boardem.
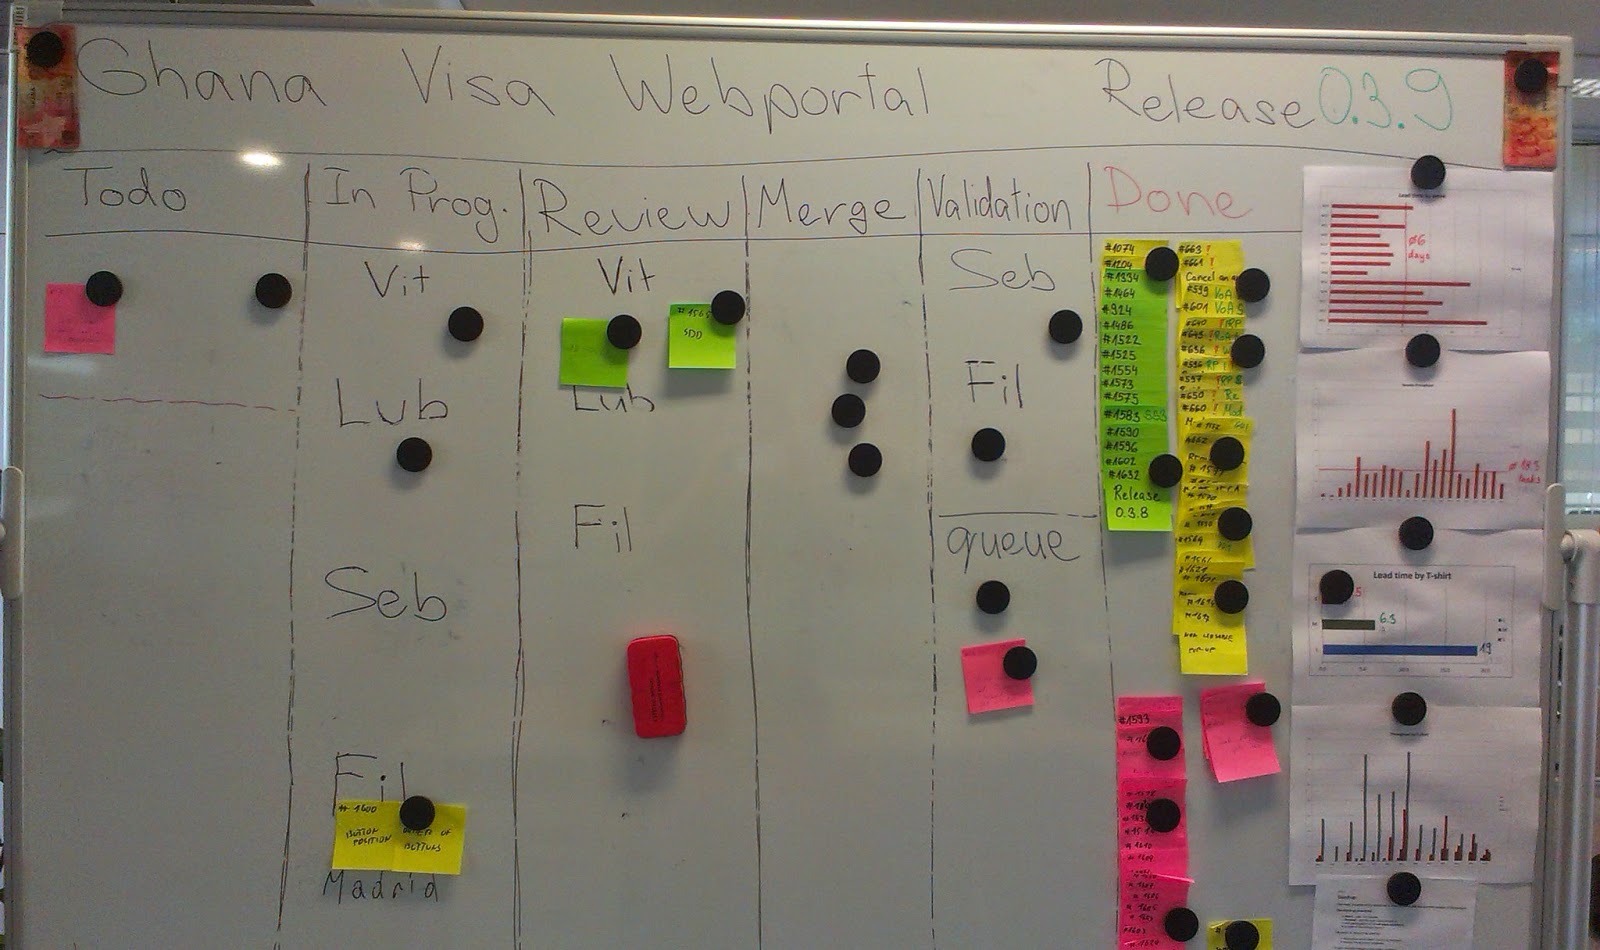
Fyzický Kanban board (stav na koneci projektu)

Co stojí za zmínku na fyzickém boardu: je zde název projektu a číslo aktuálního releasu, grafy statistik (viz dále), bankovky přivezené ze služební cesty. Předpokládám, že stavy workflow jsou samo-vysvětlující. Assignment jsem řešili pomocí labelů (Vit, Lub, Seb atd.).

Design kartiček

Na kartičkách, které na fyzickém boardu představují jednotlivé tasky, může být spousta informací. Na rozdíl od elektronické verze, kde bývá spousta atributů, má kartička jen omezený prostor. Proto je potřeba zvážit, jaké informace na ni dát, aby byla zároveň informačně dostačující a přitom srozumitelná. Velmi podrobně se tomuto tématu věnuje (výborná) kniha Kanban in Action.

My jsme začali a skončili u jednoduchého designu:
  • ID z ITS ve formátu #nnn (levý horní roh).
  • Zjednodušený název/summary tasku (uprostřed).
  • Zkratka komponentu/feature/user story (zeleně, pravý horní roh).
  • Délka setrvání ve stavu In Progress (červené tečky dole, tečka = den).
  • Indikátor kritické priority (červený vykřičník, nahoře uprostřed).
  • Indikátor blokace (červené B, pravý dolní roh).

Design kartiček

Class of Service

Když jsme projekt začínali, měli jsme všechny kartičky žluté. Postupně jsme pak zavedli classes of service. U tohoto konceptu je podstatné, že každá třída má přiřazenou specifickou politiku, jak s ní zacházet. Má třeba jiné workflow, jinou prioritu atd.

My jsme prvně odlišili tasky a bugy jiným workflow a bugy jsme na boardu odlišili růžovými lístečky (červené nebyly ;-)  Protože jsme měli zero bug policy, měl každý bug vždy vyšší prioritu než task.

Později jsme zavedli ještě jednu třídu pro tasky - má neintuitivní název intangible (termín přejímám z knihy Kanban in Action). Do téhle třídy spadají tasky, které nemají přímou, hmatatelnou business hodnotu, nicméně je potřeba je udělat. Jsou to věci jako různé konfigurace, interní dokumentace, refactoring apod. Tato třída měla (s výjimkou přípravy releasu) prioritu nižší, než task.

Třídy služeb (Classes of Service): žlutý - task, růžový - bug, zelený - intangible

Limit WIP

Moje zkušenost je zatím taková, že limitování WIP (Work In Process), je pro účastníky tou nejproblematičtější položkou Kanbanu - lidi vždycky nadávají, když jsou alokovaný na víc než jeden projekt, ale budou do krve hájit svůj "multi-taskinig". Myslím, že tady nás čeká ještě dlouhá cesta pomalé a trpělivé implantace principu stop starting, start finishing.

Malou podporu Kanbanu v Redminu už jsem zmiňoval. Limit WIP v něm nejde nastavit, tak jsme si ho definovali "jenom" jako politiku - každý by měl pracovat v daný čas jenom na jednom tasku. Fungovalo to jen z půlky dobře, vývojáři obvykle toto "omezení" dodržovali, testeři obvykle ne. Celkově bych ale řekl, že pokud je WIP nastavený jenom politikou, může to i přesto dobře fungovat. Chce to jen trpělivě lidi vzdělávat, jít příkladem a s klidem to vyžadovat. Poučení pro mne - být důslednější.

S WIP jde velmi často ruku v ruce otázka, co s blokovanými tasky? Není na to jednoduchá odpověď, částečně se to dá řešit flow, nebo politikou. Ale asi nejlepší je mít poučený tým - jak jsem kdesi četl (možná že Agile Samurai?) "zkušený agilní vývojář nikdy nezačne task, který není schopný dokončit". Čili prvně si task "před-nalyzovat" a odstanit rezistence a pak se teprve do něj pustit. Ne vždycky to jde, ale autonomní a uvědomnělý přístup členů týmu (opak skočím do toho pohlavě, neboli jdu rovnou bušit) mi dost často chybí.

Manage Flow

Kanban má rád autonomní lidi. Já taky. Kanban je pull system - když dám něco do TODO, vyhovuje mi, když to nemusím nikomu přiřazovat, ale libovolný člen týmu si to (podle svých schopností) vezme na starost. Jako team leaderovi mi to šetří obrovské množství času.

Jeden člen týmu měl s tímhle přístupem silný problém, bylo to pro něj příliš volné, "bez pravidel". Opět platí: vysvětlovat, vzdělávat. Plus, Kanban holt není pro každého, někdy si lidé a proces nesednou.

Workflow tasku na tomhle projektu je jedna z věcí, které se nám, myslím, dost povedly. Jedním z podstatných rysů flow byla silná podpora formalizovaného code review (můžete se těšit, až o tom Banter napíše článek).

Za zmínku stojí stav merge. Původně to byl jenom pseudo-stav (neměl svůj obraz v ITS). Ale vzhledem k asynchronní povaze našeho code-review procesu a občasné distribuovanosti týmu (home office, služební cesty), se vyplatilo z něj udělat svébytný stav.

Workflow tasku

Na počátku projektu jsme měli také samostatný stav pro blokované tasky. Ale pak jsme ho zrušili a nahradili blokujícím atributem přímo na issue. Důvod je prostý. Toto byl už druhý projekt, kde jsem měl v rámci Kanbanu stav blocked a vždycky to dopadlo stejně - tento stav se stal odkladištěm (až smetištěm) pro blokované tasky a nikdo (ani já) se moc nesnažil s tím něco dělat, odblokovat je. Řekl bych, že blocked atribute v tomhle funguje lépe a navíc není svázaný jen s jedním stavem - věci můžou být blokované ve vývoji, testování, integraci atd.

Další věc, kterou jsme v rámci flow zavedli byla fronta pro tasky čekající na otestování. Projekt byl z hlediska testerů podhodnocený, takže tasky se nám tam hromadily zcela přirozeně. V Kanbanu je to pěkně vidět - když se vám někde začnou štosovat lístečky, máte (možná) problém. Z hlediska teorie jde o úzké hrdlo a obvykle stojí za to ho trochu rozšířit, nebo odstranit.

My jsme to řešili dvěma způsoby: jednak jsme se zaměřili na automatizaci (Selenium testy), což pomohlo pouze částečně (testy fungovaly spíše regresně, než že by testovaly nově vyvinuté tasky) a jednak jsme úspěšně zalobovali za alokaci dalšího testera.

Statistiky

Se správou flow souvisí také jeho měření. Statistiky jsme používali, ale až takový přínost to pro nás nemělo. Z několika důvodů:
  • Se sbíráním statistik jsme začali pozdě. To bylo dané hlavně téměř nulovou podporou a využitelností reportingu v Redminu. Polovinu údajů pro statistiky bylo potřeba získávat ručně. I při malém týmu to bylo dost pracné.
  • Změny v našem flow byly celkem drobné. Ve spojení s předešlým bodem, je otázka, jak moc by se změny projevily a jak by to bylo průkazné.

Takže to byla spíš taková zajímavost a zkušenost pro příští projekt. Metriky, které jsme sbírali, byly throughput (propustnost, velocita) a lead time (trvání dokončení tasku).

Týdenní velocita

Statistiky jsme dělali jak pro "obecné" issue, tj. task bez ohledu na jeho typ a velikost, tak pro tasky odhadnuté pomocí triček (T-shirts). Ze statistiky tak např. vyplývá, že průměrná velocita týmu za týden byla 6 tasků, a průměrné dokončení tasku odhadnutého jako S trvalo 2,5 dne. (Dokončení je myšleno tak, jak ho chápe Kanban, takže vyvinuto, zreviewováno, otestováno, deployováno.)

Lead Time podle relativní velikosti tasků

Explicit Policies

Explicitní politiky jsou důležité. Je pak nad čím diskutovat a není to hospodská tlachačka o něčem "co všichni ví" a "takhle se to vždycky dělá". Obecně, nemělo by jich být moc, měly by být jednoduché a měly by být snadno přístupné. Naše politiky jsme měli na projektové wiki a zahrnovaly:
  • Stand-up: jaký je jeho smysl a jaké má pravidla.
  • WIP = 1: každý dělá v daný čas pouze na jediném tasku.
  • Zero Bug Policy: každý reportovaný bug je automaticky kritický a musí být opraven, než se začne pracovat na novém tasku.
  • Pravda je v ITS: primární zdrojem stavu projektu je trackovací systém. Každý je zodpovědný za aktuálnost a synchronizaci svých tasků.
Co mi chybělo a ocenil bych, je Definition of Done. Tak příště.

Implement Feedback, Improve Collaborativelly

Na rovinu, tyhle dvě věci nám moc nešly. Sice jsme měli retrospektivy, ale nevzpomínám si, že by to nějak ovlivnilo věci kolem Kanbanu, flow apod. Na jednu stranu to trochu chápu - tým byl Kanbanem nepolíbený, a autonomním se člověk nestane přes noc. Vysvětlovat, vzdělávat, působit. Chce to čas.

Pravidelné týmové aktivity

Následující praktiky nejsou součástí Kanbanu. Ale velice dobře se s ním pojí.

Stand-up

Denní stand-up, agilní to klasika. Pro popis bude nejjednodušší, když ocituju naši politiku:

The main purpose of the stand-up is that the team get the current context of the project.

The stand-up should be:
  • short - max. 10 minutes,
  • focused - see the main purpose above,
  • with participation of the all team members,
  • in front of the Kanban board.
The stand-up shouln't be used for:
  • discussions which don't involve all the team,
  • solving the technical problems.
If such situation happens (discussion, problem),
  • it should be rather solved after stand-up,
  • ideally in the phone box rather than in open-space,
  • only with people who are interested/involved in the problem.
The typical stand-up participation is:
  1. What did I do yesterday?
  2. What will I do today?
  3. What is blocking me.

U stand-upů se mi opět potvrdilo, to co u jiných agilních praktik - lidi, kteří s tím nemají zkušenost, můžou prvně "frfňat". Ale jen do té doby, než "to začnou dělat". Pak přijde něco jako prozření. Problém s akceptací jsme měli u jednoho člena týmu, ale potom, co jsme si to vysvětlili a deklarovali výše uvedenou politiku, už to bylo v pořádku.

Že to dobře fungovalo, můžu ilustrovat faktem, že tým nepotřeboval týdenní statusy (byly by zbytečné), protože stav všichni pobrali během stand-upů.

Retrospektivy

Retrospektivy jsme začali dělat cca v půlce projektu. Pro mne to bylo premiérové téma, proto jsem nechal retrospektivy řídit zkušenějšího kolegu a sám jsem se ponořil do studia. Hodně mi v tom pomohla kniha Agile Retrospectives.

Retrospektivy jsou pro mne ještě příliš čerstvé téma, takže je zatím nebudu hodnotit. Ale pocitově, intuitivně z nich mám dobrý pocit a chci je použít na dalším projektu.

Prioritizace

Prioritizovat je potřeba snad na každém projektu. Někdy víc, někdy méně formálně. V Kanbanu to může být stěžejní záležitost. U nás jsme se domluvili, že prioritizaci budou dělat technical a project leader. Naplánovali jsme to týdně na páteční ráno, aby bylo od pondělí jasno, co si lidi můžou brát.

Moc to nefungovalo, sešli jsme se jen párkrát. Přesto to nějak jelo bez větších zádrhelů, možná tomu napomohla automatická prioritizace vyplývající z classes of service (viz výše). U většího projektu by to asi byl dost problém. Prostě další oblast pro zlepšení.

Odhady

Na projektu jsme zavedli relativní odhady tasků pomocí triček (T-shirt estimations). Používali jsme velikosti S, M, L a XL. Pokud něco mělo velikost XL, bylo potřeba to dále rozbít na menší části. Pro odhadování samotné jsme používali planning poker s odpovídajícími hodnotami karet.

Odhady jsme dělali jednou týdně, většinou to zabralo hodinu. Členové týmu si stěžovali, že to jde pomalu (odhadne se toho málo), na druhou stranu oceňovali diskuzi, která nad tasky vznikla a umožnila tak lépe pochopit daný problém.

Odhady jsme začali dělat přibližně ve stejné době jako retrospektivy, takže neměly tak velký přínos, jak by mohly, kdybysme s nimi začali už na začátku projektu. Pozitivně vnímám, že je dělal celý tým. Naučili jsme se, jak používat trička a na dalším projektu budeme pokračovat.

Zhodnocení

Toto je druhý projekt, kde jsem aplikoval Kanban a potvrdilo se mi, že je to životaschopný a přínosný nástroj. Jako u všeho, co je tvořeno "měkkými" pravidly, hodně záleží na poučenosti lidí v týmu. Jednou z hlavních zkušeností je pro mne: vysvětlování není nikdy dost - tady se budu muset ještě hodně zlepšit. Ale doufám, že už jsem své kolegy naočkoval a příště to bude zase o něco snadnější.

Myslím, že učednická léta už mám v Kanbanu za sebou. Teď je potřeba zaměřit se na pokročilejší témata a zlepšit a dotáhnout do konce věci, jako jsou metriky, třídy služeb, plánování a odhady, používání modelů ad.

Už teď je jasné, že Kanban použiju na příštím projektu. Takže cca za rok si budete moci přečíst další díl tohoto článku. Nebo seriálu? ;-)

Mind Map


Související články

20. července 2014

Code review checklist

Nedávno jsem v práci prezentoval, jaké přínosné věci používáme na aktuálním projektu. Vyzkoušeli jsme si spoustu zajímavých nástrojů a praktik a v podstatě to byla taková laboratoř, kdy ty funkční záležitosti použijeme na dalším projektu. Mind mapa níže shrnuje přehled prezentovaných témat.

Jedním z nejcennějších realizovaných konceptů pro mne je, že se nám podařilo naimplementovat funkční a efektivní code review. (Doufám, že kolega Banter o tom brzy napíše článek.) A co čert nechtěl, po zmiňované prezentaci se nejvíc diskutovalo právě code review. Jedním z výstupů téhle diskuze je, že by bylo dobré mít nějaký code review checklist.

Já takový checklist nemám, protože ke code review přistupuju intuitivně (což ale neznamená, že nevím, co přesně chci, naopak). Nicméně pro potřeby diskuze jsem si sesumíroval, co by v takovém checklistu mohlo být.

Pozitivní věci na projektu (code review je fialový)

Co je to code review?

Ač se pojem code review používá v oblasti softwarového inženýrství dosti zhusta, má celkem nejednoznačný obsah. Pro někoho to je výsledek nástrojů jako je SonarQube, PMD, FindBugs ad. Tyto nástroje řeší tzv. statickou analýzu kódu a jsou výbornými pomocníky při udržování kvalitního kódu.

Ale code review, tak jak ho chápu já, začíná tam, kde tyto nástroje končí. Prostě tam, kde stroje selhávají, či nestačí, přichází ke slovu "stará dobrá ruční práce". Dalo by se to také nazvat jako asynchronní peer review.

Co je to code review checklist?

Checklist ((kontrolní) seznam bodů) slouží k tomu, abychom na něco nezapomněli. Třeba koupit chleba a mlíko cestou z práce. V případě code review jde o to, nezapomenout projít některý z aspektů, které chceme v rámci review kontrolovat.

Hlavní oblasti

Věci, které tak nějak intuitivně kontroluji při code review by se daly shrnout do těchto základní oblastí:
  • Konvence
  • Design
  • Best-practices
  • Závislosti
  • Pokrytí testy

Konvence

Kdekoliv dochází k nějaké sociální interakci, jsou přítomny konvence. Buď již existují, nebo se začnou vytvářet. V dnešní době, kdy je vývoj software téměř vždy týmovou prací, je taková sociální (u některých programátorů a adminů spíše asociální) komunikace nevyhnutelná. Z hlediska code review, bych vypíchnul dva body, pro které je dobré konvence nastavit a dodržovat/kontrolovat:
  • Formátování zdrojového kódu napomáhá jeho čitelnosti, pochopitelnosti, orientaci v něm atd. Tahle oblast se dá z větší části kontrolovat pomocí statické analýzy kódu (např. v Javě nástroj Checkstyle), ale některé věci zkrátka nejde nacpat do (automatických) pravidel. Domluvte se na nich, dodržujte je a váš reviewer vás bude mít rád ;-)
  • Pojmenování. Věci by měly mít správná jména. Bude pak jasné, k čemu slouží, když se o nich budeme bavit, budeme více méně na stejné platformě a kdokoliv nový to lépe a rychleji vstřebá. Typicky, je dobré mít jmennou konvenci pro komponenty, balíčky, třídy, metody a proměnné. A cokoliv dalšího, co dává smysl a bude se vyskytovat ve více instancích.

Konvence jsou velmi rozsáhlé téma. A stejně jako u spousty dalších věcí, o kterých budu psát, dochází k jejich přesahu do jiných oblastí. Berme to rozřazení do základních kategorií jako velmi volné.

Design

Tohle je moje oblíbené téma, a tak zde budu mít nejvíc položek. Je to taky z toho důvodu, že kontrola designu je pro mne jedním z hlavních cílů code review. Kdybych si měl vybrat jenom jeden aspekt, který revidovat, byl by to jednoznačně design.
  • Konceptuální diskuze. Důvod, proč často zamítnu reviewovaný kód je, že zavádí nějakou konceptuální změnu designu, která nebyla předem diskutovaná. Tohle má dvě složky. Jedna je subjektivní - mám určité designové preference a jelikož jsem většinou zodpovědný za architektonická rozhodnutí, tak je to moje právo a zodpovědnost. Druhá složka je týmová - pokud někdo "partizánsky" propašuje změnu, která bude ovlivňovat ostatní členy týmu, je to jasný důvod k zamítnutí. (Jen pro jistotu, partizánský zde má negativní konotace.) Obojí se dá jednoduše řešit zavedením designových review, kterých se účastní celý tým a kde se řeší design ještě před implementací.
  • Testovatelnost. Nejsem TDD evangelista (v dnešní době?!), ale koncept a zkušenosti s unit testy mne jako vývojáře hluboce ovlivnily. Myslím si, že největší přínos a benefit unit testů je, že mají pozitivní vliv na design produkčního kódu. Kód, který je obtížně testovatelný, je prostě špatný.
  • Konzistence. Systém/aplikace by měl být konzistentní napříč různými vrstvami, tj. odpovědnost jednotlivých vrstev/komponent, přístup ke zpracování výjimek, používané datové typy (třeba by pomohl kanonický datový model), přístup k logice (objektově, funkcionálně) atd.
  • Znovupoužitelnost. Na úrovni knihoven, komponent, tříd, metod.
  • SOLID. Systém/aplikace by měl respektovat dané/zvolené paradigma. V případě OOP by měl být "SOLIDní". Takže: Single responsibility, Open-close, Liskov substitution, Interface segregation, Dependency inversion. A objektový. Atd.
  • Logování by mělo být smysluplné, odpovídající a se správnou severitou a formátováním. Občas mě zaráží, jak málo vývojáři přemýšlí u logování nad tím, že aplikace poběží většinu svého životního cyklu na produkci.
  • Vyvarovat se: duplicity, komplexity, zanořené logiky (cykly, podmínky), věcí napevno napsaných v kódu (hardcoded). A smrtelně nebezpečné choroby DIY.

Zdroj: Dilbert.com

Best-practices

Best-practices asi není úplně nejlepší název pro tuto kategorii. A určitě není vyčerpávající a jistě mi leccos propadlo sítem.
  • Kód by měl být čitelný a srozumitelný. Čitelný znamená, že po něm "oko dobře plyne", čemuž můžou napomoci konvence. A srozumitelný ve smyslu, že business logika by měla být jednoduše pochopitelná.
  • Externalizace. Některé věci by v kódu neměly být vůbec: konfigurace, internacionalizace, to co patří do properties, řetězce literálů. Často je něco řešeno konstantama, místo použití enumů.
  • Okomentovaný kód. Jestli je v kódu Javadoc se dá zkontrolovat statickou analýzou kódu. Jestli jsou ty komentáře aktuální, smysluplné a říkají to, co by měly, to už nám žádný nástroj neřekne. Pokud je kód čitelný a pochopitelný, mělo by v komentáři být popsaný hlavně výjimečné, či překvapující chování.
  • Zakomentovaný kód. Jednoznačně vyhodit! Už nikdy se nepoužije a bude tam hnít roky.
  • Neadresné TODO. Podobně jako zakomentovaný kód. Pokud mají vaši vývojáři potřebu si psát do kódu TODO, ať se tam aspoň podepíší. Stejně už se k tomu nejspíš nikdy nevrátí. Možná je to moje úchylka, ale nesnáším (měsíce, či roky staré) TODO v produkčním kódu.
  • Komity do VCS by měly být malé, časté, smysluplné a měly by řešit pouze jedinou věc. A měly by mít rozumný komentář, ideálně nastavený konvencí. Když vidím komit/changeset, kde někdo opravil "půlku internetu", otevírá se mi imaginární kudla v kapse.

Závislosti

Ve zkratce, měli bychom si dát pozor, co nám kdo do aplikace/systému zatáhne. To se týká hlavně externích knihoven, ale také interní závislostí mezi jednotlivými vrstvami a komponentami.

Není to tak dávno, co jsem si tuhle říkal "proč je ta (Java EE) aplikace tak veliká?". Vypíšu si strom závislostí a ona je tam přibalená půlka Springu?!? Uf.

Pokrytí testy

Přiznám se, jednou jsem dělal na aplikaci, která měla 96% pokrytí testy. Ale jinak, nejsem žádný fanatik přes testy. Nicméně "rozumné" a "dostatečné" pokrytí testy by aplikace měla mít. Zejména business logiky. Naopak, není potřeba testovat platformu, či frameworky.

A kde je ten checklist?

Jak jsem psal v úvodu, tento článek je zamyšlením, co by v code review checklistu být mohlo. Možná, kdybych přemýšlel dost dlouho, tak bych dal dohromady i nějaký reálný checklist. Ale nechci. Mám rád, když jsou nastavená nějaká pravidla, ale musí umožňovat dostatek volnosti. Aby se dalo dýchat, aby nepotlačovaly invenci a motivaci. Diskuze je daleko důležitější, než mít nějaký papír na odškrtávání.

Mind map