31. října 2016

GeeCON Prague 2016, den 1

Letos jsem to nevychytal co se týče školení - prostě jsem to úplně vypustil - a tak jsem si řekl, že se aspoň trochu zahojím na nějaké konferenci. A protože jsem už pár let po očku sledoval GeeCON, resp. jeho pražskou odnož, padla volba na něj.

A vybalím to na vás hned na začátku: Je to dobrá konference, stojí za to, na ni jít. Určitě mají (kluci polský) ještě co zlepšovat. Ale celkově je to přínosný - ať chcete držet prst na tepu doby (= bleeding edge), mít všeobecný přehled, co se v doméně děje, anebo najít inspiraci - to vše tady najdete v rozumně vyvážené symbióze.

Keynote

Keynote byly dvě - první sponzorská, do počtu, naštěstí jen 20minutovka a druhá, která se pro mne stala vrcholem dne.

Next Gen R&D: craft vs. chop-shop

Keynote Ondřeje Krajíčka (@OndrejKrajicek) ze sponzorujícího Y Softu byla krátká a... neinspirativní. Úplně jsem nepochopil souvislost mezi názvem a obsahem přednášky - možná v obsahu bylo něco o R&D, ale asi mi to uniklo. V podstatě šlo o to, že jako vývojáři jsme zároveň vědci, umělci i řemeslníci (scientists, artists/artisans, craftsmen) a že učednictví, jako způsob výuky, je s námi spousty (stovky) let.

Become a Polyglot by learning Java!

Keynote Jaroslava Tulacha (@JaroslavTulach) nejlépe shrnuje následující tweet:

Nadšení bylo na místě, takhle má prostě vypadat správná key note - nemusíte se nutně posadit na zadek, ale nějaký wov! moment by tam měl být. A to se tady podařilo.

Během 50 minut, představil Jaroslav dvě věci: Graal VM a Truffle. Graal je nová virtuální mašina, která se integruje s HotSpotem (prý stačí jen na classpath "upustit" Graal JAR), která umožňuje běh různých jazyků - JVM i ne-JVM (resp. ne jejich JVM, ale nativní implementaci), třeba JavaScript a Ruby.

Toho se týkala i všechna tři dema. V prvním šlo o zavolání Ruby metody z JavaScriptu (nebo naopak?). Druhé demo ukazovalo jakýsi cross-debugging: prostě debugguju, debugguju, jsem v Ruby, ještě chvilku debugguju a jsem v JavaScriptu. A vidím šechno, proměnný atd. Cool, hustý, hustokrutý. Třetí demo jsem myšlenkově trochu vypustil, ale myslím že šlo o Node.js.

Jestli jsem to správně pochopil, tak Truffle je nástroj na psaní vlastních jazyků, který pak můžou běžet v Graalu a rovnou mají dobrou performance. Co dobrou, jsou rychlý jak sviňa. To byla taky jedna z věcí, kterou Jaroslav předváděl/říkal - že Graal VM má lepší performance, než HotSpot (v případě Javy), nabo nativní implementace Ruby. Ukazoval to na prográmku, který implementoval Eratosthenovo síto.

Věc, která mě zaujala, když Jaroslav zmiňoval problematiku JVM a dynamických jazyků: vývojáři zaměřený na aplikace (např. NetBeans) preferují staticky typované jazyky. Naopak vývojáři zaměřený na data (např. astronomové) preferují dynamické jazyky. Na tom by něco být mohlo (i když pro mě to neplatí - vzdycky jsem dělal aplikace, a začínal jsem na dynamických jazycích, takže (ne)existenci typů neřeším).

Čtvrtek

Celkově hodnoceno, první den GeeCONu byl slabší, než ten následující - vyjma Graal/Truffle key note a přednášky o graph DB, šlo o průměrné přednášky. Ne nezajímavé a určitě ne ztráta času, ale přeci jen... slabší.

Who's Afraid of Graphs?

Přednáška Davida Ostrovskyho (@DavidOstrovsky) o grafových databázích pro mne byla toho dne nejzajímavější a nejpřínosnější. David je určitě velký fanoušek filmu Spaceballs, jímž vydatně špikoval demo, a filmů Mela Brookse. A taky se podílí na vývoji Couchbase, což je dokumentová NoSQL databáze. Nicméně tentokrát hovořil o "konkurenci".

Zajímavá byla hned úvodní myšlenka - NoSQL databáze jsou s námi cca 10 let. Relační DB zhruba 40 let. Ale grafy jsou s náma minimálně 300 let. Mimo jiné zmiňoval matematický problém Seven Bridges of Königsberg, kterým se zabýval Euler v 18. století.

David zmiňoval use casy pro využítí grafových databází a zároveň uvedl a hned zavrhl nejčastější případ - sociální sítě. K tomu hned za chvíli. Dalšími příklady užití jsou authorizace a herní ekonomiky (game economies). A obecně případy, kdy jde použít "statické dotazy".

Proč nepoužívat grafové databáze pro sociální sítě? Protože neškálují. Doslova "graphs don't scale". Procházet celý graf pro každý dotaz? To asi Facebook nedělá. Co s tím? David doporučoval dvě věci: Za prvé sharding. Sice to pořád neškáluje, ale je to lepší než nic. A za druhé, rozdělit data - mít grafová data v grafové databázi (např. Neo4j) a zbývající data v relační databázi (např. MySQL).

Velkou část přednášky věnoval David praktickým ukázkám několika grafových databází. Začal tou nejpopulárnější, Neo4j a jejím dotazovacím jazykem Cypher. Cypher má specifickou notaci, kdy používá ASCII art pro reprezentaci patternů. Pro koho je Cypher moc exotický, může zkusit OrientDB, která používá SQL-like dotazování.

Problematiku dotazování řeší také další nástroj: Gremlin, jazyk pro traversální dotazování grafů. Gremlin není svázaný s konkrétní databázovou implementací, ale pomocí blueprintů se může dotazovat nad libovolnou grafovou databází. Blueprint je analogie JDBC pro grafové databáze.

Poslední ukázka se týkala Elasticsearch, kdy David ukazoval live Twitter analýzu (Hillary vs. Trump). Bylo to na mě hodně rychlé a efektní. Co mě zaujalo, možnost vytvářet virtuální grafy on-the-fly, podle momentální potřeby, tedy bez toho, aby dané vazby v datech existovaly.

Ten Productivity Tips for Java EE and Spring Developers

U přednášky Simona Maplea (@sjmaple) ze ZeroTurnaround nepřekvapilo, že na závěr zpropagoval dva jejich nástroje, nicméně nebylo to nijak násilné a do konceptu to zapadalo.

Ohledně produktivity zmiňoval tři oblasti: komunikaci, správu tasků a nástroje. Komunikaci věnoval Simon minimum prostoru. V podstatě řekl, že komunikace je klíčová, mnohem náročnější, pokud je vzdálená (remote) a dobrým nástrojem pro distribuovanou komunikaci je Slack. Myslím si, že v reálném životě má největší přínos pro produktivitu právě komunikace, ale chápu, že se to na vývojářské konferenci špatně prezentuje.

Doporučení ohledně správy tasků je přímočaré:
  • Optimizing current tasks
  • Removing non-essential tasks
  • Retaining positive (process, activities, tools etc.)

Nejvíce prostoru věnoval Simon nástrojům a z nich nejvíce JBoss Forge. Tenhle nástroj mě zatím zcela míjel, takže jestli jsem to správně pochopil, jde o JBossí odpověď na scafolding. No, řekl bych, že v dnešní době celkem passé. Co mě trochu zarazilo - vzhledem k zaměření přednášky - že Simon v demu preferoval Maven před Gradlem. Buď si tu ukázku ulehčil, nebo tak trochu ztrácí na kredibilitě.

Další nástroje zahrnovaly Arquillian (JUnit-like testování v kontejneru), TomEE (Java EE extension/profil pro Tomcat), Spring Boot (RAD(?) ve Springu) a konečně v úvodu zmiňovaný JRebel a XRebel. Výčet sice hezký, ale asi nic, co by seniorního vývojáře překvapilo. Osobně mě to neinspirovalo si ani jeden nástroj vyzkoušet.

Shrnutí Simonovy přednášky znělo:
  • Care about your time
  • Don't lose sight of your goal
  • Explore productivity tools

Apache Cassandra: building a production app on an eventually-consistent DB

Oliver Lockwood se na úvod zeptal, kdo sleduje fotbal. A kdo sleduje Premier League. Oliver pracuje pro televizi Sky, která je držitelem licence na vysílání Premier League. Jak to spolu souvisí? Sky používá pro persistenci jejich Online Video platformy databázi Apache Cassandra.

Cassandra je NoSQL distribuovaná databáze pro správu velkých dat. Z úvodu si pamatuju, že jeden node (náhodně vybraný loadbalancerem) je pro daný příkaz řídící pro zbytek clusteru. Pro databázi se definuje replication factor, tj. kolik kopií záznamu chci mít na jednotlivých nodech. A že při synchronizaci vyhrává poslední zápis (last write wins).

K čemu není Cassandra dobrá? Pokud potřebujete komplexní dotazy, nebo něco jako RDBMS transakce. A co může být na Cassandře problematické? Synchronizace času mezi jednotlivými nody. Co s tím? Buď používat synchronizační timestamp na straně klienta, nebo se "časově citlivým" (time-sensitive) dotazům vyhnout.

Poslední část přednášky byla o rozvoji DB schématu. Ve Sky si na to napsali vlastní nástoj cqlmigrate, dostupný na GitHubu. Nástroj napomáhá automatizaci, může provádět přírůstkové změny na jednotlivých nodech.

Machine Learning by Example

Pro mne nejslabší přednáška tohoto dne. Téma prezentované Michałem Matłokou (@mmatloka) bylo sice zajímavý, ale asi nešťastně zpracovaný. Předně, věnoval příliš mnoho času úvodu do tématiky, což nejspíš bylo zbytečný - každý, kdo měl aspoň trochu podobný předmět na škole (u nás se to jmenovalo "Expertní systémy") se asi trochu nudil.

Takže use casy - rozpoznání hlasu, detekce obličeje, analýza podvodů (fraud analysis), self-driving cars. Typy učení - supervised, unsupervised, semo-supervised a reinforcement learning. A citát z Alana Turinga.

A pak, bez nějakého přechodu, skok rovnou do dema, kdy jsem nepochopil, co se děje. Ukázka byla založená na použití nástrojů Apache Spark a Zeppelin, ale neptejte se mě, jak spolu souvisí. Demo bylo dlouhé a já jsem se v prvních 5 minutách ztratil, takže jsem zbytek přednášky protweetoval.

Definition of Done: Working Software in Production

Poslední čtvrteční prezentace (kterou jsem absolvoval) od Thomase Sundberga (@thomassundberg), byla přesně ten typ přednášky, který nesnáším:
  1. Vyberete si podle anotace,
  2. Přenáška začne
  3. Cca v půlce si říkáte, o čem to vlastně je,
  4. Podíváte se znovu (stále během přednášky) do anotace, abyste si připomněli, na co jste to šli
  5. a cca 5 minut po přednášce vám dojde, jak spolu souvisí titul a obsah.
  6. Jenže tu není žádný aha! moment, protože nic tak nového jste se nedozvěděli.

A přitom to vlastně tak špatná přednáška nebyla. Takže o co šlo? Continuous Delivery. A co že je tím DoD? Váš software v produkci. A teď, jak na to:
  • Převezměte kontrolu nad buildem - musí být triviální spustit build lokálně jedním příkazem.
  • Všechno verzujte - tady se to trochu rozjíždělo s tím, že dávali na produkci SNAPSHOTY (už se nepamatuju proč).
  • Automatizujte testování.
  • Procvičujte (practice) - prvně v testu, pak na produkci.
  • Perfect is not a place, it is a direction.
  • A hlavně: Začněte s málem a vydržte. Každé zlepšení se počítá.

No a pak vám s tím, samozřejmě, pomůžou nástroje. V Thomasově případě to byly: Git, Jenkins, Puppet, Gradle, RPM a JFrog.

Pátek

Vzhledem k tomu, že jsem se slušně rozepsal, rozlomil jsem článek ve dví. Mé dojmy z pátečního GeeCONu si můžete přečíst na odkazu GeeCON Prague 2016, den 2. (strpeníčko... dejte mi trochu času to napsat ;-)

Mind Map

GeeCON Prague 2016 - Key Note, organizace a témata

GeeCON Prague 2016, den 1.

Související články

4. října 2016

Software Engineering, má rozumné paralely?

Konstantou Software Engineeringu (SE) je jeho dynamika. Snad právě proto hledáme paralely a podobenství v jiných oblastech lidské činnosti - abychom lépe porozuměli jeho zákonitostem, uchopili jeho abstraktní nehmotnost a někdy ;-)  i jen našli pevnou půdu pod nohoma.

Nejčastějšími doménami, kam se sahá pro inspiraci a popis jsou: "klasická" architektura a stavebnictví (stavíme sofware), strojní výroba (vyrábíme software) a automobilový průmysl (procesní a automatizovaná výroba od designu po prodej). Tyto paralely jsou hodnotné, protože umožňují průmět, projekci něčeho obecně známého do něčeho, o čem někdy tušíme pouze fuzzy obrysy.

Auta, domy, nebo továrny?

Tak jak jsou tyto paralely přínosné, tak jsou zároveň zavádějící. Což není nijak překvapivé - architektura má za sebou tisíce let vývoje. První automobil vznikl někdy v 19. století. Pokud bychom tedy chtěli srovnávat softwarový vývoj s automobilovým průmyslem, bylo by adekvátnější, kdybychom to dělali s fází, kdy ještě nebyl průmyslem. Tedy v dobách, kdy byly zhruba jasné požadavky, ale každý je implementoval po svém.

Automobil Benz z r. 1885 (zdroj Wikepedia)

Tehdy ještě nebyla žádná standardizace. Postupně vznikala unifikace, normy, automatizace, globalizace. Tyhle tendence lze také vysledovat i v oblasti SE. Ale pořád to každý dělá tak nějak po svém.

Pokud máme k dispozici standardizované komponenty (třeba cihly), lze z nich skládat komplexní řešení. Ale nejen to - dá se také přesně spočítat (s rozumnou odchylkou) koncová cena, v návrhu se dají zohlednit jejich fyzické vlastnosti (např. stabilita cílového řešení) atd. Tohle všecno v SE chybí.

Marnost, samá marnost

Lidé z byznysu už dlouhá léta sní o tom, jak se bude software skládat z jednotlivých "krabiček" (= komponent), ale kromě marketérů, kteří se snaží taková řešení prodat, nejspíš nikdo nevěří tomu, že by to fungovalo.

Z mojí zkušenosti se nejdál v tomto směru dostaly nástroje a systémy z oblasti SOA (a nijak překvapivě, hlavně ty komerční). Do určíté úrovně (abstrakce, či návrhu) lze řešení vytvářet "taháním kostiček a šipek". Ovšem od této hranice níž nastává, námi vývojáři běžně zažívaná, realita - ty "kostičky" je potřeba naimplementovat a to už jsme na poli klasického softwarového vývoje.

Kompozitní aplikace v Oracle SOA Suite (zdroj Oracle)

Samozřejmě, hodně by zde pomohla znovupoužitelnost. Ale ruku na srdce - už jste někdy viděli, že by reusabilita fungovala na úrovni komponent? Já teda moc ne. Obvykle bývá problém v governance - dozvíte se, že to není pořeba, není to ve scopu projektu, verzování je zbytečná práce navíc, řešení (zpětné) kompatibility je moc náročné atd. Takže řekněme, že... znovupoužitelnost je hezký, ale teoretický koncept. Zatím. Oni se to lidi časem naučí. Tak jako se naučili stavět domy a auta.

Jiným problémem SE je, že se nezabývá jednou (byť třeba rozsáhlou) doménou, jako třeba stavebnictví, ale zasahuje v podstatě do jakékoliv oblasti. V takovém prostředí se pak velmi těžko extrahují nějaké principy, o které se lze opřít v příštích projektech. Proč asi agilní vývoj neslibuje nic konkrétního, ale spíš něco ve stylu "bude to kvalitní, budeme to neustále zlepšovat, ale nevíme přesně, co to nakonec bude" :-)

Vanitas vanitatum. Byť se někteří z nás věnují SE celý svůj produktivní život a pokud zůstanou zdravými programátory, tak snad i zbytek života; tak z hlediska pomíjivosti je SE stále ještě v dětských letech (ne-li v plenkách). Třeba se za sto let naši potomci a následovníci ohlédnou zpět a budou nás litovat, v jakých krutých a nestabilních podmínkách jsme budovali svá díla. A po dalších staletích, až vznikne nové vědecké odvětví - softwarová archeologie - budou vzdálené generace stát v úžasu nad tím, co jsme dokázali vytvořit holýma rukama. (Anebo taky ne.)

Má to smysl?

Pokud se kruhem vrátím zpátky na začátek - má smysl hledat pro SE nějaké paralely? Myslím si, že ano. Pomůžou s porozumněním komplexních řešení a problémů, na které lidská mysl není designovaná. Ale je potřeba to brát s rezervou... software zkrátka nemá čtyři kola.

Související externí články


25. června 2015

Jak dělám Java pohovor III: phone screen

Technickému recruitingu se věnuji už nějaké čtyři roky. Je to činnost, která mě hodně baví a tak jako u jiných aspektů své práce, jsem si vypěstoval určitý postup. Zároveň se snažím věci pořád zlepšovat a korigovat, jak studiem, tak praxí.

Phone Screen

Jedna z věcí, ke kterým jsem došel a považuji ji za nutnost, je phone screen. Jediný případ, kdy ho nedělám, je buď že mám s daným člověkem přímou pracovní zkušenost, anebo jsme se předtím už osobně setkali - to se stává, pokud třeba někdo zareaguje na můj inzerát.

Poslední dobou si hodně čtu o agilním přístupu (i po těch letech se člověk pořád má co učit) a věc, která se mi stále vrací a furt si ji musím připomínat - každý mítink musí mít smysl. Fajn, jaký je tedy pro mne smysl phone screenu? Podívejme se, co stojí v soukromém samurajském slovníku:

Phone Screen: Je to první, krátký a efektivní kontakt s potencionálním kolegou, který zodpoví jedinou otázku - má smysl se osobně vidět a pokračovat ve vzájemném získávání informací?

Proč používám termín phone screen a ne třeba "telefonní pohovor"? Inu, to proto, že je to krátké a přesně to vystihuje svůj účel. Uznejte - "telefonní filtrování" zní blbě samo o sobě a poslat kandidátovi pozvánku s takovým předmětem by asi nebylo zrovna vstřícné. 

Struktura

Můj phone screen má vždy stejný začátek. Zavolám, představím se jménem a firmou a řeknu: "Tento phone screen by měl trvat 30 minut a projdeme si následující kroky:
  1. představím se já,
  2. představí se kandidát z hlediska technologií,
  3. technické otázky,
  4. kandidátovy otázky."
Pak si cca 30 minut povídáme, během té doby bedlivě sleduji čas, a po půl hodině rozhovor ukončím.

Pokud se podívám blíže na jednotlivé body:

Představím se já, tedy, znovu zopakuji svoje jméno, řeknu svoji formální pozici a krátce vysvětlím obsah své práce. Myslím si, že je to fér vůči kandidátovi - dát mu nějaký kontext, aby věděl, s kým asi tak mluví.

Představí se kandidát z hlediska technologií. Jediná informace, kterou o kandidátovi v tento moment mám, je zpravidla pouze jeho CV. Což je dost slabá a nevěrohodná informace. Požádám proto kandidáta, aby se mi představil z hlediska technologií. Zdůrazním, že mě nezajímá klasické "odříkávání" životopisu, stejně tak, jaký byl business význam projektů, nebo aplikací, na kterých se podílel. Co mě zajímá, je jeho současný technologicko-seniorní "snapshot".

Myslím, že je to celkem logické - nenajímám odborníka na nějakou business doménu, ani business analytika, ale vývojáře. Takže mě zajímají technologie, frameworky, architektura atd. Bohužel, lidé dost často tuto otázku ignorují a spustí naučený kolovrátek. Pokud se tak stane (pořád sleduju ten čas), vrátím je zpátky k původní otázce.

Technické otázky. Jedním z cílů předchozí části je zjistit kandidátovy silné technologické stránky. Říkám o sobě (ohledně pohovorů), že jsem hodný, ale spravedlivý. Takže se ho ptám na věci, o kterých říká, že je dobře zná. Samozřejmě, musím ty věci dobře znát i já. Ale vzhledem ke svému stáří a senioritě ;-) vždycky najdeme slušný průnik. Někdy se i kandidáta přímo zeptám: "Jaké jsou momentálně dvě Vaše nejsilnější technologie?".

No a pak začneme na povrchu, u triviálních a základních věcí a jdeme hloub a hloub, až se někde naše znalosti zastaví - narazíme na lokální minumum. Pokud se to stane, nebo se téma vyčerpá, nebo pokud přes veškerou snahu zůstaneme stále na hladině, přejdu k dalšímu (silnému) tématu.

Pro představu jak může tahle část vypadat, dejme tomu, kandidát říká, že dobře zná JPA, či Hibernate. Můžeme začít třeba otázkou "Na jakém principu tahle technologie funguje?", nebo "Jaký je vztah mezi JPA a Hibernate?".

Pak se podíváme na mapování pomocí metadat. Můžou to být otázky typu "Které dvě anotace/XML elementy jsou nezbytně nutné, aby framework mohl používat (POJO) třídu jako entitu?", či "Které anotace při mapování běžně používáte?". Podstatné je, že nevyžaduji přesné názvy, ale jestli kandidát rozumí o čem mluví a principům, na kterých to funguje.

A jdeme hlouběji - jaké mohou být vztahy mezi entitami, jaké jsou strategie pro získávání dat a která z nich je defaultní pro daný typ vztahu? Jak se řeší složené klíče? Na téhle úrovni složitosti často opustíme mapování entit a podíváme se na jiná zajímavá témata - přece jenom, děláme phone screen a času je málo.

Můžeme si popovídat třeba o EntityManageru, nebo o Session. Pokud nám to spolu klape, můžeme se dostat až k transakcím, nebo co to je PersistenceContext a PersistenceUnit. Někdy dokonce dojde i na lifecycle entit :-)

Ať už se dostaneme kamkoliv, je podstané, jak jsme si o tom popovídali. Už jsem zmiňoval, nejde mi o žádné odříkávání slovníkových dat a in-memory znalostí. Jde mi o porozumnění a rozsah, které by mělo odpovídat dané úrovni seniority. Jednotlivé otázky, jak úvodní, tak usměrňující vybírám intuitivně, nemám žádný mustr, podle kterého jedu.

Když se čas nachýlí, je prostor pro kandidátovy otázky. Kandidát mi věnoval cca 25 minut svého času a tak je fér mu otevřeně zodpovědět, co by ho zajímalo. Možná si říkáte, že 5 minut na otázky není moc, ale většinou to bohatě stačí - moje zkušenost je taková, že nadpoloviční většina lidí nemá žádné otázky, nebo tak jednu dvě. Pokud je někdo zvědavější a má otázek víc, i já mu (rád) věnuji víc času.

Zakončení

Jakmile jsou otázky za náma, zbývá říct už jen dvě věci - co bude následovat a rozloučení. Co následuje po rozhovoru? Za pomocí svých poznámek (viz dále) sepíšu jednoduché hodnocení s pozitivním, nebo negativním výsledkem, který se kandidát vzápětí dozví. Pozitivní skóre se rovná pozvání na osobní pohovor.

Jak si píšu poznámky

Když jsem s phone screeny začínal, psával jsem si poznámky přímo do vytištěného CV. Není to dobrý způsob - každé CV je jinak formátované, velikost bílých ploch na psaní je proměnlivá, je to neuspořádané atd. Jedinou výhodou je, že CV a poznámky jsou pohromadě.

Časem jsem ale zakomponoval lepší metodu - přímo během pohovoru si kreslím mind mapu. Stejnou metodu pak používám i u osobního pohovoru (Je to konzistentní a dobře se v tom hledá). Výhodou mind mapy je, že si daleko lépe připomenete, o čem jste si povídali. A taky to lépe vypadá. Navíc, mind mapa se mnou zůstane - zpracovaná CV vyhazuji, ale mind mapy si schovávám a archivuji.


Související články

31. května 2015

Cesta samuraje, rok čtvrtý

Normálně by se řeklo, že SoftWare Samuraj slaví čtvrté narozeniny. Ale tentokrát to na žádnou velkou oslavu není - z hlediska blogování to bylo velmi slabý. A důvody jsou dost podobné jako vloni.

Maratony

Z volného času mi nejvíc ukrojilo běhání. Vloni jsem běžel dva maratony, letos také dva a jeden až dva mě ještě čekají. Myslím, že trénování na maraton (a maraton samotný) je výborná analogie k softwarovým projektům.

Třeba, že je to tvrdá dřina. Že je nesmysl sprintovat hned na začátku. Že zvítězí (či dokončí) ten, kdo má strategii. Že pokud je commitment, tak je nesrovnatelně větší šance na úspěch. A hlavně, maratony (a projekty) se "běhají hlavou".

Distribuovaný projekt

Pracovně jsem absolvoval velmi náročný projekt a jeho začátek se kreje s koncem mého psaní. Projekt byl sice krátký (od listopadu do května), ale za to vyčerpávající - je to první projekt v mé kariéře, kdy si musím vzít dovolenou, abych si odpočinul.

Proč vyčerpávající? V první řadě, to byl distribuovaný projekt. A nejen distribuovaný, ale vskutku globální - zákazník byl v Urugayi, project management ve Francii a (menší) půlka implementačního týmu v Praze a druhá půlka na Filipínách. Sice je to fráze, ale na tomhle projektu to platilo beze zbytku - communication is the key.

Druhým stěžejním důvodem byla relativní juniorita týmu. To nebyl problém z technického hlediska - technické problémy jsou ty jednodušší k řešení. Problém byl, že se nepodařilo vytvořit silnou týmovou kulturu. Samozřejmě, tohle jde z větší části za mnou, za team leaderem, a vidím to jako své selhání. Už několik měsíců jsem tak ve stadiu analýzi, proč k tomu došlo a co jsem mohl udělat jinak, nebo lépe. Hodně mi v tom pomáhá výborná kniha Coaching Agile Teams.

Na druhou stranu, když team nechce dát commitment, tak s tím nic nenaděláte a můžete se snažit, jak chcete. A je to potom náročnější pro project managera, team leadera a další, protože team na ně přesouvá zodpovědnost. A na tomhle projektu to bylo náročné velmi.

Ale nechci si stěžovat, projekt považuji za úspěšný - dodali jsme v čas, v budgetu, v rozumně dobré kvalitě a hlavně, zákazník je spokojený a chce s námi dělat další projekt.

Závazek

Již dvakrát jsem v tomto článku zmínil termín commitment. Ano, momentálně ho považuji za klíčový nástroj, který odděluje úspěšné od neúspěšného. A protože bych zase chtěl začít pravidelně psát, tady je můj závazek:
  • Napsat alespoň jeden článek měsíčně.

Související články

17. září 2014

Můj pohled na Agile Prague 2014

Byl jsem na konferenci Agile Prague. Bylo to poprvé a hned tak se tam nevrátím. Ne, že bych své účasti litoval - našel jsem si tam pár zajímavých myšlenek a odkazů na dodatečné zdroje. Ale celkový dojem z konference mám rozpačitý - pro koho je vlastně určena?

Shrnutí

Můžu se krutě mýlit, ale podle obecenstva bych odhadoval, že tak 70-90 % byli SW inženýři, s převahou vývojářů. Většina z nich buď už má zkušenost s agile, nebo ví o co jde, nebo aspoň po agilitě touží. Pro tuhle kategorii, obávám se, konference mohla nabídnout stěží něco nového, něco inspirativního. Teda kromě "kmenové družby". Sám za sebe bych to shrnul následujícím tweetem:

Přišlo mi, že většina přednášek by byla nejvíc přínosná pro kategorii, která na konferenci zcela/téměř absentovala - střední manažment. Nevím, čím to bylo, ale skoro všichni řečníci se drželi na velmi abstraktní rovině. Pořád se mluvilo o problémech, které agile adresuje, ale jen minimálně o konkrétních řešeních. A hlavně, srovnávat (opakovaně!) v roce 2014 (13 let po Agilním manifestu!) vodopád s agilním vývojem... hm, mlácení prázdné slámy?

Co se mi nelíbilo

V následující sekci nebudu psát pozitivní věci - chtěl bych proto předeslat: jde o můj, striktně subjektivní pohled. Pokud něco kritizuji, tak proto, že to nedosáhlo mých očekávání. Nemusí to ale říkat nic o skutečné, nebo obecně přijímané kvalitě. Jsem někdy solipsista... už od dětství.

A směrem k pořadatelům: jsem rád, že takovouto konferenci pořádáte. Vím, že je za tím spousta práce a je fajn mít něco takového v Praze.

Agile != Scrum

Tenhle pocit už mám dlouhodobě. Když "běžní" lidi mluví o agile - a řečníci na konferenci to zhusta autorizovali - tak zazní něco (byť ne tak explicitně) jako:
"Být agile" = "dělat" Scrum
Zajímalo by mě, jestli máte jinou zkušenost? Já když poslouchám diskuze o agile, tak cca 80 % času/prostoru je věnováno klábosení o Scrumu.

Jen výjimečně (a díky za to) zaznělo:
Individuals and interactions over processes and tools

Case Studies

Case studies jsem viděl dvě (Home Credit a Skype) a obě patřily k (informačně) nejslabším příspěvkům na konferenci. Když jdu na case study, tak očekávám, že se dozvím něco z toho, "jak to dělali". Nezajímá mě historie a struktura firmy. A když je na talk 20 minut, tak mě nezajímá ani kontext, v jakém to probíhalo - není na to čas. Chci vědět, jak to dělali! To jsem se ani z jedné case study nedozvěl.

Co si z toho odnáším, tak že v Home Creditu měli problém telefonovat do Asie (technické problémy) a ve Skypu použili na odhady story points, které měly konkrétní velikost (hodiny a dny - takže už jaksi nešlo o relativní, ale absolutní odhady). To asi není to, co řečníci zamýšleli předat publiku.

Zaměření, pointa přednášek

Možná jsem přespříliš kritický, ale poučen Scottem Berkunem očekávám, že přednáška bude mít nějakou pointu, myšlenku, kterou chce sdělit. O to spíš, že trvá pouze 20, 30, max. 45 minut.

Přiznám se, občas jsem se musel během prezentace opakovaně podívat do programu na název přednášky, abych si připomenul o čem je téma. A párkrát jsem se usilovně snažil do posledních sekund nalézt pointu toho, co jsem zrovna půl hodiny poslouchal.

Nekonkrétnost

Několikrát jsem na přednáškách zaslechl rady jako: "We should embrace the Agile Manifesto!", "We need to find leaders!" apod. Aspoň jak jsem to pochopil, nebyly to mobilizační výkřiky - byly to vážně míněné rady, jak řešit předeslané problémy. Ehm, jak? To je to, proč jsem přišel na tuhle přednášku, konferenci. Jak se to dá udělat? Nebo alespoň, kde se mám inspirovat, kde si to můžu dostudovat? Nevím. Nevím, v těchto otázkách víc, než jsem věděl před konferencí/přednáškou.

Bonding

Nejsem mizantrop, jsem jen bytostný introvert. A nesnáším, když mě někdo z pozice autority (řečník, nebo pořadatel) nutí dělat věci, které jsou mi jako introvertovi nepříjemné. Což je třeba diskuze ve veřejném prostoru s cizími lidmi. Nebo se ptát sponzora konference na heslo k wifi!?!?

Wifi

Myslím si, že je v dnešní době faux pas, když není na konferenci k dispozici slušná wifi... pro všechny. Aby to bylo jasné: heslo na wifi pro prvních 100 (z cca 250), není pro všechny. A to tím spíš, pokud poskytnu program konference v elektronické verzi, která vyžaduje být online.

Ano, můžou být legitimní důvody, proč není wifi připojení uspokojivé, či dostačující. Pak je ale férové to říct narovinu. A ne žoviálně odtušit "better be quick". Failure.

Co se mi líbilo

Linda Rising

Jednoznačnou hvězdou konference pro mne byla Linda Rising (@RisingLinda). Tahle agilní babička (72 let!!) doručila jedinou inspirativní keynote celé konference a i její druhá přednáška byla velmi pěkná.

Její keynote měla název The Power of the Agile Mindset a dala by se zhustit do věty Na počátku bylo slovo. Celé to bylo o tom, jakou úžasnou schopnost máme k dispozici - jedinou větou můžeme určit trajektorii skupiny na dlouhou dobu a doširoka rozevřít nůžky mezi úspěšnými a neúspěšnými. Mezi těmi, kteří hledají řešení a těmi, kdo hledají chyby a viníky. Mezi těmi, kdo na sobě pracují a kdo o sobě lžou (aby vypadali lépe). A mezi agilním a fixním mindsetem.

Paul Klipp

Paul Klipp byl jediný řečník, kterého jsem před konferencí znal. Těšil jsem se na něj a nezklamal mě. Ba co víc, překvapil mě. Jeho přednáška se jmenovala Improve your communication skills dramatically without saying a word. Jako jediný speaker mluvil bez slidů(!) a součástí byla i 3minutová meditace(!!), která však do přednášky organicky zapadla.

Je zbytečné, abych tady přepisoval a parafrázoval Paulovu myšlenku - doporučuji přečíst si jeho blogpost Improve your communication skills by learning to listen, nebo se aspoň podívat na přípravnou mind mapu.

Organizace jako doprava

Zábavná a osvěžující byla přednáška Hanse Brattberga Traffic, Organizations and Lean, kde přirovnával fungování firmy (a hlavně přístup k projektům) k dopravním situacím. Křižovatka v Hanoi, kruhový objezd na Champs-Élysées, šestiproudá dálnice, couvání v jednosměrce atd.

Každé srovnání kulhá. Ale tady nešlo o nalezení analogie, ale o zobrazení určitých zákonitostí pomocí nadsázky. Třeba že couvání v jednosměrce je vlastně podvádění (protože se nám nechce objíždět blok). Na druhou stranu, jak Lean, tak doprava pracuje s flow, kapacitou apod., takže něco podobného tam bude.

Produktové flow nestačí

I když osobně nepovažuju Kanban za (striktně) agilní záležitost, přece jen mě dost překvapilo, že na konferenci o něm nebylo vůbec nic! Nejvíc se mu blížila přednášky Martina Burnse Product Flow Is Not Enough!. De facto to bylo o Kanbanu, i když, jestli si dobře vzpomínám, tak slovo Kanban tam ani jednou nezaznělo. Nebo to bylo o Lean? ;-)

Martin měl taky velmi pěkné, ručně malované slidy, které bohužel nejsou (zatím?) dostupné. Můžete je ale vidět v jeho přednášce na YouTube. (V Praze mluvil o moc líp = plynuleji, ale Kanban fakt neřekl.)

Total Recall, eh, Terraforming

Další (nejen) zábavná přednáška byla od Caludia Perroneho: Terraforming Organisations: Journey of a Lean Changer. Tahle přednáška hodně vycházela z Toyoty a Lean, plus A3 Thinking, ale směřovala k originálním nástrojům ("myslící" karty a Popcorn flow, viz slidy níže).

Nicméně, to co mi hlavně utkvělo v hlavě, je slide kdesi z prostředka prezentace:


Krásně to ilustruje můj pocit z většiny implementací Scrumu, co jsem jich v enterprise viděl - vývojáři si vesele "scrumují" a nad nima je zabetonovaný klasický hierarchický manažment.

#NoEstimates

Na #NoEstimates jsem poprvé narazil v knize Kanban in Action. Je to zajímavá myšlenka, s Kanbanem se velmi dobře pojí a řečník Vasco Duarte ji přednesl srozumitelně. Čím se Vasco, bohužel, moc nezabýval - jak to udělat na začátku projektu. Studijními zdroji taky zrovna neplýtval - prostě to stavěl jako takové postuláty. A publikum bylo asi dost zaskočené, protože se na to taky nikdo nezeptal.

Catering

Ruku na srdce - dobré jídlo ke konferenci patří a já jsem byl spokojený. Obědy byly chutné, dortíky dobré, kafe (na konferenci) slušné, džusů dostatek, nemůžu si stěžovat :-)

Co jsem si odnesl

Ačkoliv jsem šel na agilní konferenci, tak to, co jsem si odnesl, se netýká agile, ale leadershipu - víc na sobě pracovat, jako servant leader. Takže z tohohle pohledu jsem spokojený. Ale z pohledu agile jsem zklamaný - vzhledem ke své pozici mám v práci (omezenou) možnost prosadit určité věci, nastavit kulturu, doporučit nástroje apod. A bohužel, v tomto směru si z Agile Prague 2014 neodnáším žádnou inspiraci.

Související externí články

26. srpna 2014

Mercurial, strategie branch-by-feature


Mercurial je skvělý, distribuovaný Version Control System (VCS, či DVCS), který nabízí velkou míru volnosti, jak s nakládat s verzováním zdrojových kódů. Svobodu většinou chápeme jako pozitivní věc, někdy je ale přílišná nespoutanost na škodu. A tak definování nějaké verzovací strategie prospěje týmu i projektu.

Proč mít verzovací strategii?

Verzovací strategii branch-by-feature jsme s úspěchem použili na stávajícím projektu. Důvody, proč jsme si něco takového definovali byly dva:
  • Když jsem se mihnul na předcházejícím projektu (taky Mercurial), žádná strategie, či konvence definovaná nebyla . Člověk pak slýchal řeči jako: "Proč to furt merguješ?", "Vznikaj ti tam anonymní branche." a "Tam by's měl používat rebase.". Prostě klasický, tohle-tady-všichni-ví a takhle-to-děláme-ale-tobě-jsme-to-neřekli.
  • Chtěli jsme mít na nadcházejícím projektu formalizované code review.

Takže jsme se zamysleli, chvilku nad tím špekulovali a pak jsme, spolu s podporou dalších nástrojů, došli k následující strategii.

Strategie branch-by-feature

Princip téhle strategie je jednoduchý a dá se popsat jednou větou: Pro každou novou feature (nebo bug) se založí nový branch. Hotovo, vymalováno.

A teď trochu obšírněji. Na počátku je v repozitory pouze jeden permanentní branch. Zpravidla se mu říká development branch. Z něj se odlamují další branche pro vývoj - feature branche. Co přesně tyto branche představují, záleží na granularitě položek, do kterých jsme si práci rozdrobili. Může to být user story, feature, requirement, task. Ideálně je to něco, co evidujeme v issue tracking systému (ITS).

Probíhá běžný vývoj a všechny komity jdou do (odpovídajícího) feature branche. Když je vývoj hotový, proběhne code review a pokud jsou změny akceptovány, zamergují se do development branche a feature branch se zavře. Pokud jsou změny zamítnuty, provede se náprava, komitne se do feature branche, následuje code review atd.

Pokud jsou v této fázi nalezeny nějaké bugy, přistupujeme k nim stejně jako k feature. To jest, bug branch -> code review -> merge do development branche.

Verzovací strategie branch by feature

Po nějakém čase vznikne release branch. Pokud jsou v něm nalezeny chyby, vzniká bug branch a po code review přichází merge jak do release, tak do development branche.

Celý postup se dá shrnout do následujících bodů:
  1. Vytvoření nového feature/bug branche.
  2. Development.
  3. Změny projdou code review.
  4. Uzavření feature/bug branche.
  5. (Bugfixy jsou zamergovány do release branche.)
  6. Změny jsou zamergovány do development branche.

Z pohledu příkazové řádky vypadá proces takto:
$ hg branche fb-logging
$ hg commit -m 'Logging feat. has been developed.'
$ hg commit -m 'Close branch fb-logging.' --close-branch
$ hg update default
$ hg merge fb-logging
$ hg commit -m 'Merge branch fb-logging -> default.'

Zcela záměrně se vyhýbám popisu code review. To proto, abych nekradl materiál svému kolegovi Banterovi, který již jistě brzy napíše článek, o tom, jak to děláme (je to fakt cool, tak se těšte). Nicméně, ve vztahu k Mercurialu si nemůžu odpustit, jak to vypadá procesně. Přepokládám, že všichni čtete plynně BPMN ;-)  takže dalších slov netřeba. Mercurial aktivity jsou v oranžovém rámečku.

Code Review proces (oranžové jsou aktivity v Mercurialu, modré v RhodeCode)

Drobná a příjemná vylepšení

Což o to, proces, jako takový, je pěkný. Na někoho je ale možná trochu komplexní. Přece jenom, když mastíte celý život všechno jenom do trunku, může to být trochu moc věcí najednou. Tady je pár věcí, které nám to o něco usnadnili.

Konvence

Konvence jsme měli nastavené jednak pro názvy branchů a jednak pro komitovací komentáře. Název nového branche se skládal z prefixu a čísla issue v ITS. Prefix byl buď fb- (feature branch), nebo bb- (bug branch). Např. fb-42, bb-1024.

Konvence pro komentáře by se daly rozdělit do tří skupin: běžné komentáře, při zavírání branche a při vytváření releasu. Konvence samotná by se v Mercurialu dala pohlídat pomocí hooku, ale nedokopal jsem se k tomu, ho napsat. Pro "běžné", vývojové komentáře jsme měli konvenci WIP #nnn; some comment. WIP je zkratka pro Work In Progress, nnn je id issue v ITS. Např. WIP #1561; Payment button has been removed.

Zavření branche se skládá ze čtyř Mercurial příkazů (commit, update, merge, commit, viz výše) a obsahuje dva komentáře ve formátu:
  • Close branch <branch-name>.
  • Merge branch <branch-name> -> default.

Za zmínku stojí mergovací komentář, ze kterého by mělo být jasné, odkud kam merge proběhnul.

Komentáře při zavírání branche

Releasovací komentáře byly celkem čtyři a obsahovaly klíčové slovo [Release].

Komentáře při vytváření releasu

V předešlém popisu vás možná zarazilo, že jak pro zavření branche, tak pro vytvoření releasu je potřeba spustit čtyři Mercurial příkazy. Dělat to ručně by byla značná otrava a hlavně by celá konvence brzo erodovala do chaosu. Šťastni kdož používají automatizaci, neboť jen ti vejdou do křemíkového nebe.

Mercurial alias

S používáním aliasu přišel kolega Banter, takže mu za to patří dík a rád ho zde zvěčním. Alias samotný vypadá dost ošklivě, zato jeho použití je elegantní. Jedinou vadou na kráse je, že jsme nepřišli, jak alias spustit z grafických nástojů, jako je SourceTree, nebo TortoiseHg, takže ještě budeme muset zapracovat na tom, aby tuto fičurku mohli používat i kolegové, kteří ještě nepřišli na to, jak cool je používat command line ;-)

Alias stačí přidat do souboru ~/.hgrc a spouští se jednoduchým příkazem hg close-feature nnn, kde nnn je (v našem případě) čístlo issue v ITS, tj. to, co je za prefixem fb-.
[alias]
close-feature = ![ -z "$1" ] && echo "You didn't specify a branch!" && exit 1; \
                if hg branches | grep -q "fb-$1"; \
                    then $HG up fb-$1; \
                         $HG commit -m 'Close branch fb-$1.' --close-branch; \
                         $HG pull; \
                         $HG up default; \
                         $HG merge fb-$1; \
                         $HG commit -m 'Merge branch fb-$1 -> default.'; \
                    else echo "The branch fb-$1 does NOT exist!"; \
                fi

Gradle release task

Náš projekt buildujema Mavenem. Chvilku jsem se snažil napasovat Maven Release plugin na naši branchovací strategii, ale pořád to nějak nebylo ono - je to prostě moc šitý na SVN. Pak jsem ztratil trpělivost a odpovídající chování si napsal jako Gradle task. Časem se z toho snad vyklube Gradle plugin.

Task samotný tady uvádět nebudu, protože je asi tak na tři stránky. A taky potřebuje ještě trochu poladit. Zkrátka ještě není zralý na to, abych ho dal z ruky. V podstatě ale dělá pouze to, že přepíná branche, šolichá s Mercurialem a manipuluje s verzí v pom.xml. A dělá to ty hezké komentáře, co jsem uváděl výše.

Pros & Cons

Celý výše popsaný koncept jsme vymysleli ještě před projektem. Pak přišel projekt a emotivně musím říct, že nám to krásně fungovalo. Jako hlavní benefit vidím, že jsme si formalizovali proces code review a s výše uvedenou branchovací strategií to bylo velice efektivní. Dalším plusem byla, "úhledná" práce s Mercurialem, kdy byla radost se prohrabávat verzovanou historií.

K negativům bych zařadil komplexnost. Pokud by nám nešlo o code review, asi by tato strategie byla zbytečná. Zatím mi taky chybí nějaká podpora v grafických a automatizačních nástrojích. Jako milovníkovi CLI mi to osobně nijak nevadí, ale musím myslet taky na ostatní členy týmu (bývalý kolega jim říkal "makáči" :-)  pro které by mělo být používání nástrojů co nejsnadnější.

Je to všechno?

Abyste dostali plný obrázek, jak to celé fungovalo, chybí nám jeden velký dílek skládanky - jo, code review. Takže pokud vám něco nedává smysl, tak je to možná proto, že jsem v tomto článku celkem důsledně odpáral použití dalších dvou nástrojů, které byly s branchovací strategii organicky provázané - issue tracking system a RhodeCode, nástroj, ve kterém jsme, pomocí pull requestů, řešili code review.

Popis code review je na samostatný článek. Tak snad ho Banter brzo napíše a já sem pak lísknu odkaz. A jinak doufám, že vám zmiňovaná strategie branch-by-feature přijde inspirativní.

Happy branching! :-)

Mind Map


Související články

12. srpna 2014

Kanban, zprávy z fronty II

Máme za sebou, s týmem, další, úspěšnou implementaci Kanbanu. Projekt pomalu končí, je čas se ohlédnout. Jak to vypadalo, co fungovalo, co je potřeba zlepšit?

O projektu

Vzhledem k tomu, že z bezpečnostního hlediska se jedná o citlivé téma, nebudu psát nic o architektuře a technologiích. Což ale nevadí, protože z pohledu Kanbanu je obsah a typ projektu nepodstatný. Ale ať nám to povídání nevisí ve vzduchu, nastíním business case.

Výsledkem projektu je/bude webová aplikace, s jejíž pomocí si zájemci mohou online zažádat o různé typy víz a povolení (pracovní, k pobytu apod.) a také je eventuálně online zaplatit. Aplikace, jako taková, je velmi hloupoučká, veškerá business logika a workflow zpracování žádosti se děje na backendu, který už není součástí naší dodávky.

Team

Šlo o malý projekt, takže i malý tým - 2 vývojáři, 1-2 testeři/integrátoři, 1 technical leader, 1 project leader. Celkově (a konstantně během celého projektu) nějakých pět lidí. Pouze dva členové týmu měli předešlou zkušenost s agilním vývojem, s Kanbanem pak pouze jeden. Tým byl technicky seniorní, žádný junior.

Vizualize

Základním přikázáním Kanbanu je vizualizuj! Všechno, co jde (a dává smysl), vše, co dá lepší viditelnost projektu.

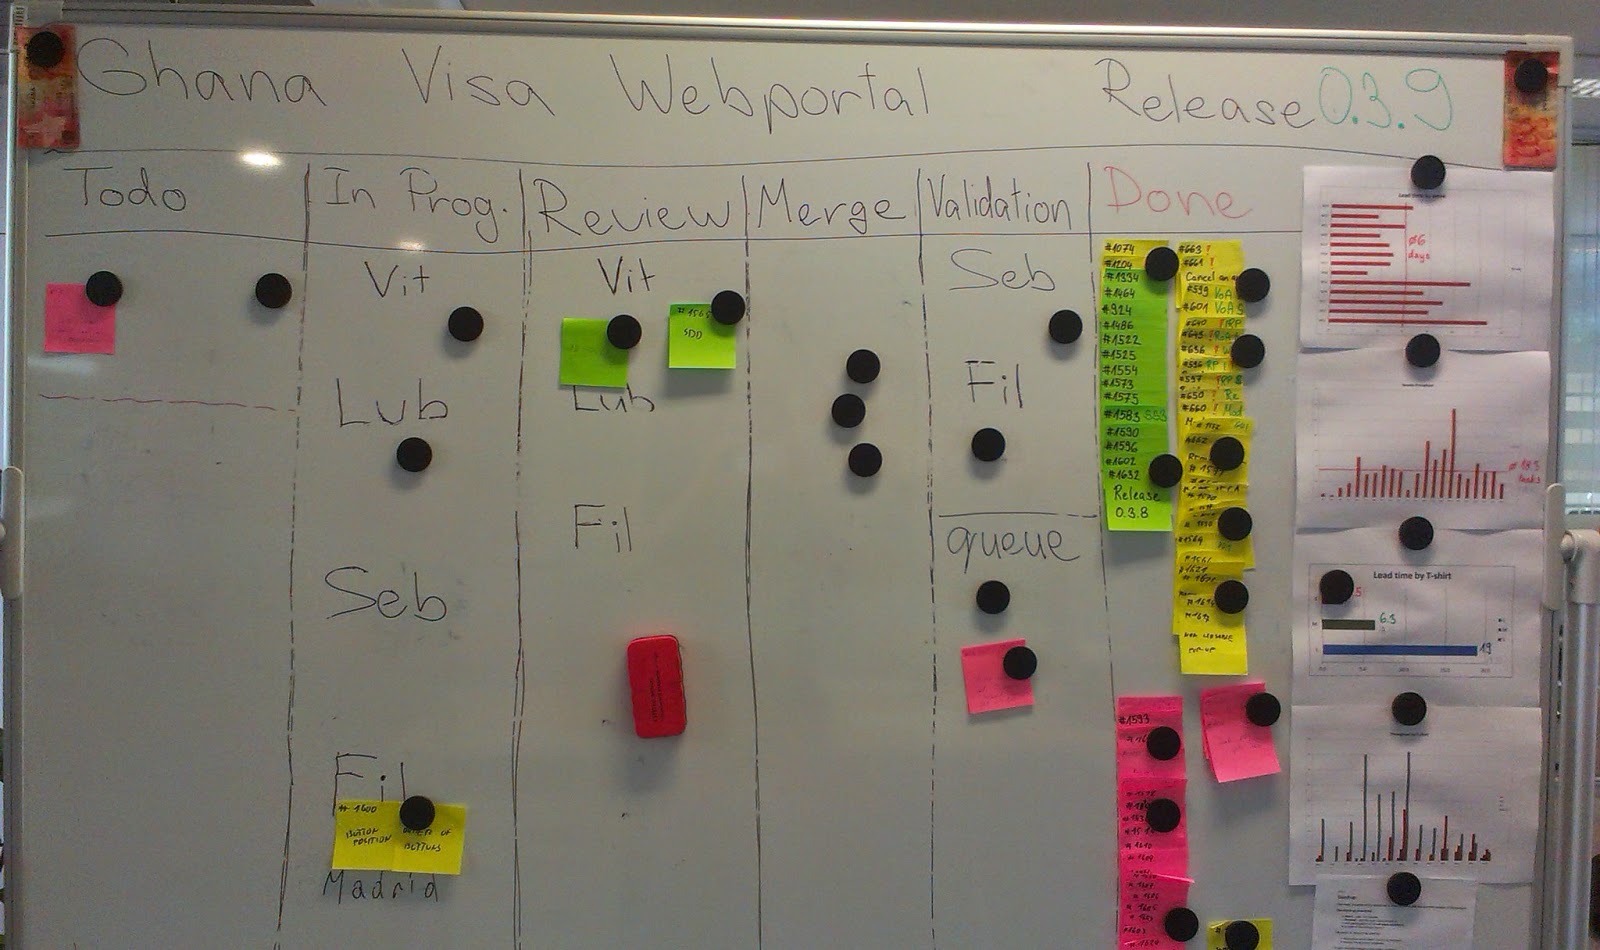
Kanban Board

První věc, která se (obvykle) vyzualizuje, je projektové/procesní workflow. Použili jsme jak fyzický, tak elektronický board. Ten elektronický byl založen na issue tracking (ITS) nástroji Redmine.

Bohužel, Redmine je, jako ITS, dosti nezralý/problematický a pro Kanban nemá žádný použitelný plugin. Problém jsme vyřešili "oklikou přes ruku" (= workaround) pomocí pluginu Wiki Lists, který dává přijatelný výsledek. Elektronický board byl primárním zdrojem informací a stavu.

Elektronický Kanban board (Redmine a Wiki Lists plugin)

Fyzický board byl druhotný zdroj informací. Používali jsme ho jako přirozené místo setkávání týmu (stand-upy). Další výhodou byla jeho neustálá přítomnost v open spacu. Takže všichni viděli :-)

Každý člen týmu byl zodpovědný za synchronizaci svých tasků mezi ITS a fyzickým boardem.

Fyzický Kanban board (stav na koneci projektu)

Co stojí za zmínku na fyzickém boardu: je zde název projektu a číslo aktuálního releasu, grafy statistik (viz dále), bankovky přivezené ze služební cesty. Předpokládám, že stavy workflow jsou samo-vysvětlující. Assignment jsem řešili pomocí labelů (Vit, Lub, Seb atd.).

Design kartiček

Na kartičkách, které na fyzickém boardu představují jednotlivé tasky, může být spousta informací. Na rozdíl od elektronické verze, kde bývá spousta atributů, má kartička jen omezený prostor. Proto je potřeba zvážit, jaké informace na ni dát, aby byla zároveň informačně dostačující a přitom srozumitelná. Velmi podrobně se tomuto tématu věnuje (výborná) kniha Kanban in Action.

My jsme začali a skončili u jednoduchého designu:
  • ID z ITS ve formátu #nnn (levý horní roh).
  • Zjednodušený název/summary tasku (uprostřed).
  • Zkratka komponentu/feature/user story (zeleně, pravý horní roh).
  • Délka setrvání ve stavu In Progress (červené tečky dole, tečka = den).
  • Indikátor kritické priority (červený vykřičník, nahoře uprostřed).
  • Indikátor blokace (červené B, pravý dolní roh).

Design kartiček

Class of Service

Když jsme projekt začínali, měli jsme všechny kartičky žluté. Postupně jsme pak zavedli classes of service. U tohoto konceptu je podstatné, že každá třída má přiřazenou specifickou politiku, jak s ní zacházet. Má třeba jiné workflow, jinou prioritu atd.

My jsme prvně odlišili tasky a bugy jiným workflow a bugy jsme na boardu odlišili růžovými lístečky (červené nebyly ;-)  Protože jsme měli zero bug policy, měl každý bug vždy vyšší prioritu než task.

Později jsme zavedli ještě jednu třídu pro tasky - má neintuitivní název intangible (termín přejímám z knihy Kanban in Action). Do téhle třídy spadají tasky, které nemají přímou, hmatatelnou business hodnotu, nicméně je potřeba je udělat. Jsou to věci jako různé konfigurace, interní dokumentace, refactoring apod. Tato třída měla (s výjimkou přípravy releasu) prioritu nižší, než task.

Třídy služeb (Classes of Service): žlutý - task, růžový - bug, zelený - intangible

Limit WIP

Moje zkušenost je zatím taková, že limitování WIP (Work In Process), je pro účastníky tou nejproblematičtější položkou Kanbanu - lidi vždycky nadávají, když jsou alokovaný na víc než jeden projekt, ale budou do krve hájit svůj "multi-taskinig". Myslím, že tady nás čeká ještě dlouhá cesta pomalé a trpělivé implantace principu stop starting, start finishing.

Malou podporu Kanbanu v Redminu už jsem zmiňoval. Limit WIP v něm nejde nastavit, tak jsme si ho definovali "jenom" jako politiku - každý by měl pracovat v daný čas jenom na jednom tasku. Fungovalo to jen z půlky dobře, vývojáři obvykle toto "omezení" dodržovali, testeři obvykle ne. Celkově bych ale řekl, že pokud je WIP nastavený jenom politikou, může to i přesto dobře fungovat. Chce to jen trpělivě lidi vzdělávat, jít příkladem a s klidem to vyžadovat. Poučení pro mne - být důslednější.

S WIP jde velmi často ruku v ruce otázka, co s blokovanými tasky? Není na to jednoduchá odpověď, částečně se to dá řešit flow, nebo politikou. Ale asi nejlepší je mít poučený tým - jak jsem kdesi četl (možná že Agile Samurai?) "zkušený agilní vývojář nikdy nezačne task, který není schopný dokončit". Čili prvně si task "před-nalyzovat" a odstanit rezistence a pak se teprve do něj pustit. Ne vždycky to jde, ale autonomní a uvědomnělý přístup členů týmu (opak skočím do toho pohlavě, neboli jdu rovnou bušit) mi dost často chybí.

Manage Flow

Kanban má rád autonomní lidi. Já taky. Kanban je pull system - když dám něco do TODO, vyhovuje mi, když to nemusím nikomu přiřazovat, ale libovolný člen týmu si to (podle svých schopností) vezme na starost. Jako team leaderovi mi to šetří obrovské množství času.

Jeden člen týmu měl s tímhle přístupem silný problém, bylo to pro něj příliš volné, "bez pravidel". Opět platí: vysvětlovat, vzdělávat. Plus, Kanban holt není pro každého, někdy si lidé a proces nesednou.

Workflow tasku na tomhle projektu je jedna z věcí, které se nám, myslím, dost povedly. Jedním z podstatných rysů flow byla silná podpora formalizovaného code review (můžete se těšit, až o tom Banter napíše článek).

Za zmínku stojí stav merge. Původně to byl jenom pseudo-stav (neměl svůj obraz v ITS). Ale vzhledem k asynchronní povaze našeho code-review procesu a občasné distribuovanosti týmu (home office, služební cesty), se vyplatilo z něj udělat svébytný stav.

Workflow tasku

Na počátku projektu jsme měli také samostatný stav pro blokované tasky. Ale pak jsme ho zrušili a nahradili blokujícím atributem přímo na issue. Důvod je prostý. Toto byl už druhý projekt, kde jsem měl v rámci Kanbanu stav blocked a vždycky to dopadlo stejně - tento stav se stal odkladištěm (až smetištěm) pro blokované tasky a nikdo (ani já) se moc nesnažil s tím něco dělat, odblokovat je. Řekl bych, že blocked atribute v tomhle funguje lépe a navíc není svázaný jen s jedním stavem - věci můžou být blokované ve vývoji, testování, integraci atd.

Další věc, kterou jsme v rámci flow zavedli byla fronta pro tasky čekající na otestování. Projekt byl z hlediska testerů podhodnocený, takže tasky se nám tam hromadily zcela přirozeně. V Kanbanu je to pěkně vidět - když se vám někde začnou štosovat lístečky, máte (možná) problém. Z hlediska teorie jde o úzké hrdlo a obvykle stojí za to ho trochu rozšířit, nebo odstranit.

My jsme to řešili dvěma způsoby: jednak jsme se zaměřili na automatizaci (Selenium testy), což pomohlo pouze částečně (testy fungovaly spíše regresně, než že by testovaly nově vyvinuté tasky) a jednak jsme úspěšně zalobovali za alokaci dalšího testera.

Statistiky

Se správou flow souvisí také jeho měření. Statistiky jsme používali, ale až takový přínost to pro nás nemělo. Z několika důvodů:
  • Se sbíráním statistik jsme začali pozdě. To bylo dané hlavně téměř nulovou podporou a využitelností reportingu v Redminu. Polovinu údajů pro statistiky bylo potřeba získávat ručně. I při malém týmu to bylo dost pracné.
  • Změny v našem flow byly celkem drobné. Ve spojení s předešlým bodem, je otázka, jak moc by se změny projevily a jak by to bylo průkazné.

Takže to byla spíš taková zajímavost a zkušenost pro příští projekt. Metriky, které jsme sbírali, byly throughput (propustnost, velocita) a lead time (trvání dokončení tasku).

Týdenní velocita

Statistiky jsme dělali jak pro "obecné" issue, tj. task bez ohledu na jeho typ a velikost, tak pro tasky odhadnuté pomocí triček (T-shirts). Ze statistiky tak např. vyplývá, že průměrná velocita týmu za týden byla 6 tasků, a průměrné dokončení tasku odhadnutého jako S trvalo 2,5 dne. (Dokončení je myšleno tak, jak ho chápe Kanban, takže vyvinuto, zreviewováno, otestováno, deployováno.)

Lead Time podle relativní velikosti tasků

Explicit Policies

Explicitní politiky jsou důležité. Je pak nad čím diskutovat a není to hospodská tlachačka o něčem "co všichni ví" a "takhle se to vždycky dělá". Obecně, nemělo by jich být moc, měly by být jednoduché a měly by být snadno přístupné. Naše politiky jsme měli na projektové wiki a zahrnovaly:
  • Stand-up: jaký je jeho smysl a jaké má pravidla.
  • WIP = 1: každý dělá v daný čas pouze na jediném tasku.
  • Zero Bug Policy: každý reportovaný bug je automaticky kritický a musí být opraven, než se začne pracovat na novém tasku.
  • Pravda je v ITS: primární zdrojem stavu projektu je trackovací systém. Každý je zodpovědný za aktuálnost a synchronizaci svých tasků.
Co mi chybělo a ocenil bych, je Definition of Done. Tak příště.

Implement Feedback, Improve Collaborativelly

Na rovinu, tyhle dvě věci nám moc nešly. Sice jsme měli retrospektivy, ale nevzpomínám si, že by to nějak ovlivnilo věci kolem Kanbanu, flow apod. Na jednu stranu to trochu chápu - tým byl Kanbanem nepolíbený, a autonomním se člověk nestane přes noc. Vysvětlovat, vzdělávat, působit. Chce to čas.

Pravidelné týmové aktivity

Následující praktiky nejsou součástí Kanbanu. Ale velice dobře se s ním pojí.

Stand-up

Denní stand-up, agilní to klasika. Pro popis bude nejjednodušší, když ocituju naši politiku:

The main purpose of the stand-up is that the team get the current context of the project.

The stand-up should be:
  • short - max. 10 minutes,
  • focused - see the main purpose above,
  • with participation of the all team members,
  • in front of the Kanban board.
The stand-up shouln't be used for:
  • discussions which don't involve all the team,
  • solving the technical problems.
If such situation happens (discussion, problem),
  • it should be rather solved after stand-up,
  • ideally in the phone box rather than in open-space,
  • only with people who are interested/involved in the problem.
The typical stand-up participation is:
  1. What did I do yesterday?
  2. What will I do today?
  3. What is blocking me.

U stand-upů se mi opět potvrdilo, to co u jiných agilních praktik - lidi, kteří s tím nemají zkušenost, můžou prvně "frfňat". Ale jen do té doby, než "to začnou dělat". Pak přijde něco jako prozření. Problém s akceptací jsme měli u jednoho člena týmu, ale potom, co jsme si to vysvětlili a deklarovali výše uvedenou politiku, už to bylo v pořádku.

Že to dobře fungovalo, můžu ilustrovat faktem, že tým nepotřeboval týdenní statusy (byly by zbytečné), protože stav všichni pobrali během stand-upů.

Retrospektivy

Retrospektivy jsme začali dělat cca v půlce projektu. Pro mne to bylo premiérové téma, proto jsem nechal retrospektivy řídit zkušenějšího kolegu a sám jsem se ponořil do studia. Hodně mi v tom pomohla kniha Agile Retrospectives.

Retrospektivy jsou pro mne ještě příliš čerstvé téma, takže je zatím nebudu hodnotit. Ale pocitově, intuitivně z nich mám dobrý pocit a chci je použít na dalším projektu.

Prioritizace

Prioritizovat je potřeba snad na každém projektu. Někdy víc, někdy méně formálně. V Kanbanu to může být stěžejní záležitost. U nás jsme se domluvili, že prioritizaci budou dělat technical a project leader. Naplánovali jsme to týdně na páteční ráno, aby bylo od pondělí jasno, co si lidi můžou brát.

Moc to nefungovalo, sešli jsme se jen párkrát. Přesto to nějak jelo bez větších zádrhelů, možná tomu napomohla automatická prioritizace vyplývající z classes of service (viz výše). U většího projektu by to asi byl dost problém. Prostě další oblast pro zlepšení.

Odhady

Na projektu jsme zavedli relativní odhady tasků pomocí triček (T-shirt estimations). Používali jsme velikosti S, M, L a XL. Pokud něco mělo velikost XL, bylo potřeba to dále rozbít na menší části. Pro odhadování samotné jsme používali planning poker s odpovídajícími hodnotami karet.

Odhady jsme dělali jednou týdně, většinou to zabralo hodinu. Členové týmu si stěžovali, že to jde pomalu (odhadne se toho málo), na druhou stranu oceňovali diskuzi, která nad tasky vznikla a umožnila tak lépe pochopit daný problém.

Odhady jsme začali dělat přibližně ve stejné době jako retrospektivy, takže neměly tak velký přínos, jak by mohly, kdybysme s nimi začali už na začátku projektu. Pozitivně vnímám, že je dělal celý tým. Naučili jsme se, jak používat trička a na dalším projektu budeme pokračovat.

Zhodnocení

Toto je druhý projekt, kde jsem aplikoval Kanban a potvrdilo se mi, že je to životaschopný a přínosný nástroj. Jako u všeho, co je tvořeno "měkkými" pravidly, hodně záleží na poučenosti lidí v týmu. Jednou z hlavních zkušeností je pro mne: vysvětlování není nikdy dost - tady se budu muset ještě hodně zlepšit. Ale doufám, že už jsem své kolegy naočkoval a příště to bude zase o něco snadnější.

Myslím, že učednická léta už mám v Kanbanu za sebou. Teď je potřeba zaměřit se na pokročilejší témata a zlepšit a dotáhnout do konce věci, jako jsou metriky, třídy služeb, plánování a odhady, používání modelů ad.

Už teď je jasné, že Kanban použiju na příštím projektu. Takže cca za rok si budete moci přečíst další díl tohoto článku. Nebo seriálu? ;-)

Mind Map


Související články